غابة عشوائية في الممارسة العملية: دليل أساسي
سوف تتعلم كيف تستفيد Random Forest من أشجار القرار لتحسين الدقة التنبؤية في مجموعات البيانات المعقدة.
المقدمة
غابة عشوائيةإحدى خوارزميات التعلّم الآلي الأساسية التي اكتسبت شهرة واسعة في علم البيانات بفضل فعاليتها في التعامل مع مهام التصنيف والانحدار. ويكمن سرّ نجاحها في قدرتها على بناء أشجار قرار متعددة أثناء عملية التدريب، وإخراج القيمة الأكثر تكرارًا للفئات (في حالة التصنيف) أو متوسط التنبؤ (في حالة الانحدار) لكل شجرة على حدة. صُمّم هذا الدليل التمهيدي لتبسيط مفهوم الغابة العشوائية للمبتدئين، من خلال تقديم شرح واضح ومفصّل خطوة بخطوة لكيفية عملها، إلى جانب دليل عملي لتطبيقها باستخدام Python. هدفنا هو تزويد القراء بالمعرفة اللازمة لفهم الأسس النظرية للغابة العشوائية وتطبيقها بفعالية في مشاريعهم في علم البيانات، مستفيدين من إمكانيات البرمجة القوية للغة بايثون.
إضاءات
- تتفوق Random Forest على أشجار القرار الفردي من خلال تقليل التجهيز الزائد.
- يؤدي ضبط المعلمة الفائقة في Random Forest إلى تحسين دقة النموذج بشكل كبير.
- تعد المعالجة المسبقة للبيانات أمرًا محوريًا للنجاح التنبؤي لـ Random Forest.
- يعمل دليل Python خطوة بخطوة على تبسيط تنفيذ Random Forest.
- يتضمن تقييم نماذج الغابة العشوائية الدقة والإحكام ومقاييس الاستدعاء.
عنوان الاعلان
وصف الإعلان. لوريم إيبسوم دولور سيت أميت، consectetur adipiscing إيليت.
فهم الغابة العشوائية
غابة عشوائيةهي خوارزمية تعلم آلي تعتمد على مفهوم أشجار القرار لتوفير نموذج تنبؤي أكثر دقة وقوة. تقوم بإنشاء العديد من أشجار القرار أثناء التدريب، وتُخرج الفئة، أي النمط الأكثر تكرارًا للفئات (في التصنيف) أو متوسط التنبؤ (في الانحدار) للأشجار الفردية.
كيف تعمل الغابة العشوائية:
أشجار القرار: تبدأ خوارزمية الغابة العشوائية بأشجار القرار، وهي نماذج بسيطة لاتخاذ القرارات تشبه الأشجار. تُعطي كل شجرة في الغابة العشوائية تنبؤًا، وتعتمد الخوارزمية على تصويت الأغلبية أو المتوسط في حالة الانحدار كناتج نهائي.
التمهيد: تقوم هذه التقنية باختيار مجموعة فرعية عشوائية من مجموعة البيانات لكل شجرة، مما يضمن التنوع بين الأشجار ويساهم في متانة النموذج.
التجميع (التجميع): تقوم الخوارزمية بعد ذلك بتجميع تنبؤات الأشجار الفردية لإنتاج تنبؤ أكثر دقة واستقرارًا.
مزايا الغابة العشوائية:
تقليل التجاوز في التخصيص: على عكس أشجار القرار الفردية التي غالبًا ما تعاني من التجاوز في التخصيص لبيانات التدريب، تُخفف الغابة العشوائية من هذا الخطر من خلال نهجها التجميعي. يضمن حساب متوسط التنبؤات من أشجار متعددة عدم اعتماد التنبؤ الإجمالي للنموذج بشكل مفرط على أي جزء منفرد من بيانات التدريب، مما يؤدي إلى نتائج أكثر قابلية للتعميم.
دقة عالية: تكمن قوة خوارزمية الغابة العشوائية في تجميعها للتنبؤات من أشجار قرار متعددة، يتم تدريب كل منها على مجموعات فرعية مختلفة من نفس البيانات. تعمل هذه الطريقة التجميعية على تعزيز دقة التنبؤ بشكل ملحوظ، متفوقةً على العديد من أساليب النموذج الواحد عبر مجموعات بيانات وأنواع مشاكل متنوعة.
تعدد الاستخدامات: يسمح تصميم خوارزمية الغابة العشوائية لها بالتفوق في مهام متنوعة، بدءًا من التنبؤ بالنتائج الفئوية في مسائل التصنيف وصولًا إلى تقدير المتغيرات المستمرة في تحليلات الانحدار. كما أن قدرتها على التعامل بكفاءة مع مجموعات البيانات التي تحتوي على قيم مفقودة، ومعالجتها للبيانات الرقمية والفئوية دون الحاجة إلى معالجة مسبقة مكثفة، تجعلها مرنة للغاية.
رؤى حول أهمية الميزات: من أبرز قدرات خوارزمية الغابة العشوائية آلية اختيار الميزات المدمجة فيها. فمن خلال تحليل تأثير كل ميزة على دقة التنبؤ عبر جميع الأشجار، تستطيع الغابة العشوائية ترتيب أهمية الميزات ضمن مجموعة البيانات. تُعد هذه الرؤية بالغة الأهمية لفهم العوامل الدافعة وراء التنبؤات، ويمكنها توجيه عملية اختيار الميزات في تحسين النموذج وعمليات تحليل البيانات عمليات.
تطبيقات الغابة العشوائية:
مالية: تُستخدم خوارزمية الغابة العشوائية على نطاق واسع في القطاع المالي للقيام بمهام بالغة الأهمية مثل تقييم مخاطر الائتمان من خلال تحليل درجات الائتمان والتنبؤ بالتحركات المستقبلية في سوق الأسهم، مما يساعد في وضع استراتيجيات الاستثمار.
التجارة الإلكترونية: تعمل هذه الخوارزمية على تحسين تجارب التسوق عبر الإنترنت من خلال دعم أنظمة التوصيات التي تقترح المنتجات بناءً على سلوك المستخدم وتفضيلاته. كما أنها تلعب دورًا محوريًا في تقسيم العملاء إلى مجموعات متميزة لتوجيه استراتيجيات التسويق والترويج.
الرعاية الصحية: في المجال الطبي، تُسهم خوارزمية الغابة العشوائية في الكشف المبكر عن الأمراض من خلال تحليل بيانات المرضى بحثًا عن أعراض تُشير إلى حالات مرضية مُحددة. كما تُساعد في تصنيف المرضى إلى مجموعات خطر، مما يُسهل وضع خطط علاجية مُخصصة.
الأمن السيبراني: بالنظر إلى التطور المتزايد للتهديدات السيبرانية، تساعد تقنية الغابة العشوائية في الكشف والتنبؤ في الوقت المناسب بالاحتيال المحتمل والاختراقات الأمنية، وذلك بالاستفادة من اكتشاف الشذوذ في أنماط البيانات لحماية الأصول الرقمية.
الأسس النظرية للغابات العشوائية
غابة عشوائيةعلى مبدأ التعلم الجماعي، حيث يتم دمج مصنفات متعددة، في هذه الحالة أشجار القرار، لحل مشكلة معقدة وتحسين أداء النموذج.
شرح تفصيلي للخوارزمية:
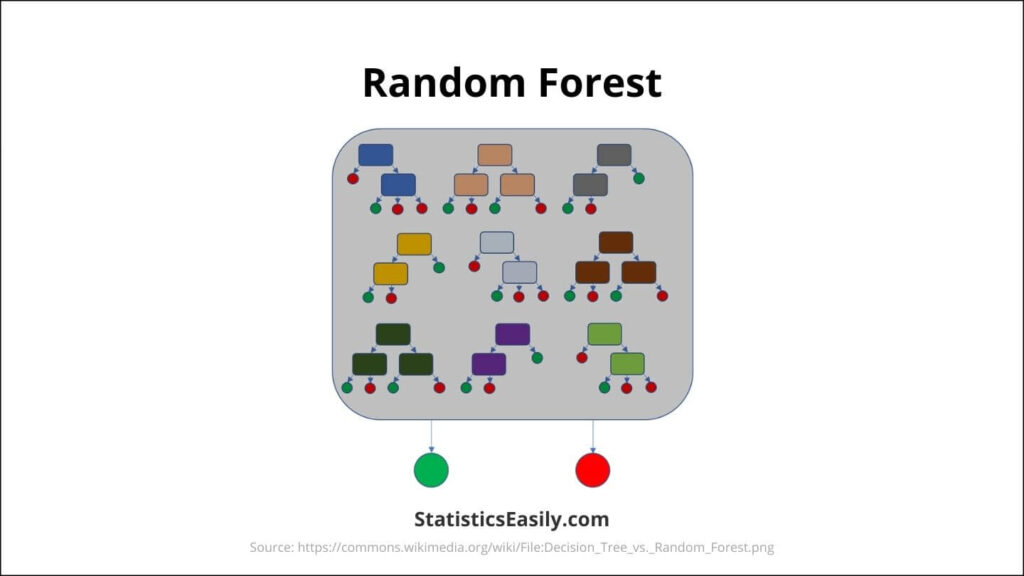
مجموعة من أشجار القرار: تقوم الغابة العشوائية بإنشاء غابة من أشجار القرار غير المرتبطة، يتم تدريب كل منها على مجموعات فرعية عشوائية من بيانات التدريب، باستخدام تقنية التمهيد.
اختيار الميزات العشوائي: تختار كل شجرة مجموعة فرعية عشوائية من الميزات عند كل تقسيم. تساعد هذه العشوائية على جعل الأشجار أكثر تنوعًا، مما يزيد من دقة النموذج بشكل عام.
التجميع: يتم تحديد التنبؤ النهائي لنموذج الغابة العشوائية من خلال تجميع تنبؤات الأشجار الفردية. يقلل هذا التجميع من التباين، ويتحكم في فرط التخصيص، ويحسن دقة التنبؤ للنموذج.
المعلمات الفائقة وتأثيرها:
عدد الأشجار (n_estimators): زيادة عدد الأشجار بشكل عام يحسن أداء النموذج ولكنه يزيد من التكلفة الحسابية.
أقصى عمق (max_depth): يتحكم في عمق كل شجرة. يمكن للأشجار الأعمق أن تلتقط أنماطًا أكثر تعقيدًا، ولكن قد يؤدي ذلك إلى فرط التخصيص.
الحد الأدنى لعدد العينات اللازمة للتقسيم (min_samples_split): يحدد هذا الخيار الحد الأدنى لعدد العينات المطلوبة لتقسيم عقدة داخلية. القيم الأعلى تمنع النموذج من تعلم أنماط محددة للغاية.
الحد الأقصى للميزات (max_features): حجم المجموعات الفرعية العشوائية من الميزات التي يتم أخذها في الاعتبار عند تقسيم عقدة. يؤثر ذلك على تنوع الأشجار في الغابة.
قياس الفعالية:
الدقة: هي نسبة المشاهدات المتوقعة بشكل صحيح إلى إجمالي المشاهدات. وهي مقياس قيّم لمشاكل التصنيف المتوازن.
مصفوفة الارتباك: تحليل مفصل لأداء النموذج، بما في ذلك الإيجابيات الحقيقية، والسلبيات الحقيقية، والإيجابيات الخاطئة، والسلبيات الخاطئة.
الدقة، والاستدعاء، ومقياس F1: الدقة هي نسبة التنبؤات الصحيحة للقيم الإيجابية إلى إجمالي التنبؤات الإيجابية. الاستدعاء (الحساسية) يقيس نسبة التنبؤات الصحيحة للقيم الإيجابية إلى إجمالي القيم في الفئة الفعلية. مقياس F1 هو المتوسط المرجح للدقة والاستدعاء. تُعد هذه المقاييس بالغة الأهمية في سياق مجموعات البيانات غير المتوازنة.
تحضير بياناتك
تعد المعالجة المسبقة الفعالة للبيانات خطوة حاسمة في التعلم الآلي والتي تؤثر بشكل كبير على أداء نماذج مثل Random Forest. يوضح هذا القسم الخطوات الأساسية لتنظيف البيانات وإعدادها، مما يضمن تنظيم البيانات على النحو الأمثل لنمذجة الغابات العشوائية.
أهمية المعالجة المسبقة للبيانات:
تعمل المعالجة المسبقة للبيانات على تحويل البيانات الأولية إلى مجموعة بيانات نظيفة يمكن استخدامها مباشرة لنماذج التعلم الآلي. تعتبر هذه العملية حيوية لأنها تؤثر بشكل مباشر على قدرة النموذج على التعلم وإجراء تنبؤات دقيقة. بالنسبة إلى Random Forest، حيث يتم تضمين أشجار قرارات متعددة، تضمن المعالجة المسبقة الاتساق والجودة عبر مجموعة البيانات، مما يسمح للخوارزمية بتحديد الأنماط بشكل أكثر فعالية.
خطوات تنظيف البيانات وإعدادها:
1. معالجة القيم المفقودة: يمكن لخوارزمية الغابة العشوائية معالجة القيم المفقودة إلى حد ما. ومع ذلك، يُنصح عمومًا بتعويض القيم المفقودة باستخدام استراتيجيات مثل تعويض المتوسط للبيانات العددية وتعويض المنوال للبيانات الفئوية.
2. ترميز المتغيرات الفئوية: تحويل المتغيرات الفئوية إلى تنسيق رقمي من خلال تقنيات الترميز مثل الترميز الأحادي الساخن أو ترميز التصنيفات، حيث لا تستطيع الغابة العشوائية معالجة البيانات النصية الخام.
3. قياس الميزات: على الرغم من أن الغابة العشوائية ليست حساسة لقياس الميزات مثل خوارزميات مثل SVM أو KNN، إلا أن ضمان أن تكون جميع الميزات على نفس المقياس يمكن أن يساعد في تحسين تقارب النموذج وقابلية تفسير درجات أهمية الميزات.
4. إزالة الميزات غير ذات الصلة: تخلص من الميزات التي لا تُساهم في التنبؤ أو التي قد تُسبب تشويشًا. على الرغم من أن خوارزمية الغابة العشوائية تختار الميزات عشوائيًا أثناء التدريب، إلا أن تقليل الأبعاد مُسبقًا يُمكن أن يُقلل من وقت التدريب وتعقيده.
تقسيم مجموعة البيانات:
مجموعات التدريب والاختبار: قسّم بياناتك إلى مجموعات تدريب واختبار لتقييم أداء النموذج على بيانات غير مرئية. النسبة النموذجية للتقسيم هي 70:30 أو 80:20، حيث يُستخدم الجزء الأكبر للتدريب.
التحقق المتبادل: ضع في اعتبارك استخدام تقنيات التحقق المتبادل، وخاصة التحقق المتبادل k-fold، لضمان أن يكون أداء النموذج متسقًا عبر مجموعات فرعية مختلفة من البيانات.
تطبيق عملي للغابات العشوائية مع بايثون
يجمع تطبيق خوارزمية الغابة العشوائية فيPythonبفعالية بين الفهم النظري للخوارزمية ومهارات البرمجة العملية. يرشدك هذا القسم خلال إعداد بيئة بايثون، وتطبيق خوارزمية الغابة العشوائية باستخدام مكتبةsklearn، وتطبيقها على مجموعة بيانات حقيقية.
مثال عملي: التنبؤ بأنواع القزحية
تحتوي مجموعة بيانات القزحية على 150 نباتًا للقزحية، مُصنفة إلى ثلاثة أنواع بناءً على أربع ميزات: طول الكأس، وعرض الكأس، وطول البتلة، وعرض البتلة. يتعلم نموذج Random Forest من بيانات التدريب ويتنبأ بدقة بأنواع نباتات القزحية.
باتباع الخطوات الموضحة أدناه، يمكنك تنفيذ Random Forests في Python لمجموعات بيانات متنوعة، وليس فقط لمجموعة بيانات Iris. اضبط المعلمات الفائقة للنموذج، مثل n_estimators وmax_deepth، لتحسين الأداء استنادًا إلى مجموعة البيانات والمهمة المحددة لديك.
تم تصميم مقتطفات التعليمات البرمجية المقدمة لتكون سهلة المتابعة، مع شرح لكل خطوة لتسهيل الفهم والتنفيذ. يوضح هذا التطبيق العملي قوة الغابات العشوائية في النمذجة التنبؤية. فهو يوفر أساسًا متينًا لاستكشاف مشاريع علوم البيانات الأكثر تعقيدًا.
إعداد بيئة بايثون الخاصة بك
للعمل مع Random Forest في Python، تأكد من تثبيت Python على جهازك. استخدم الحزم التالية:
- نمباي: للتعامل مع المصفوفات والمصفوفات.
- الباندا: لمعالجة البيانات وتحليلها.
- سكيكيت ليرن (sklearn): يوفر خوارزمية Random Forest ووظائف إضافية لبناء نماذج تنبؤية.
- ماتبلوتليب/سيبورن: لتصور البيانات ونتائج النماذج.
قم بتثبيت هذه الحزم باستخدام النقطة:
pip install numpy pandas scikit-learn matplotlib seaborn
تنفيذ غابة عشوائية مع sklearn
تتضمن وحدة sklearn.ensemble RandomForestClassifier لمهام التصنيف وRandomForestRegressor لمهام الانحدار. فيما يلي دليل خطوة بخطوة لاستخدام RandomForestClassifier:
1. استيراد المكتبات الضرورية:
from sklearn.ensemble import RandomForestClassifier
from sklearn.model_selection import train_test_split
from sklearn.metrics import accuracy_score, confusion_matrix, classification_report
import pandas as pd
import matplotlib.pyplot as plt
import seaborn as sns
2. تحميل مجموعة البيانات الخاصة بك:سنستخدم مجموعة بيانات Iris، وهي مجموعة بيانات كلاسيكية في أمثلة التعلم الآلي، لهذا المثال.
from sklearn.datasets import load_iris
iris = load_iris()
X = iris.data
y = iris.target
3. تقسيم مجموعة البيانات:قسّم بياناتك إلى مجموعات تدريب واختبار لتقييم أداء النموذج.
X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.3, random_state=42)
4. تهيئة وتدريب النموذج:قم بإنشاء نسخة من RandomForestClassifier وقم بتدريبها على بيانات التدريب الخاصة بك.
clf = RandomForestClassifier(n_estimators=100, random_state=42)
clf.fit(X_train, y_train)
5. إجراء التنبؤات وتقييم النموذج:استخدم النموذج المدرب للتنبؤ بمجموعة الاختبار وتقييم الدقة.
y_pred = clf.predict(X_test)
print(f"Accuracy: {accuracy_score(y_test, y_pred)}")
النتائج النموذجية والتفسير
بعد تدريب النموذج ووضع التنبؤات، من المهم تفسير النتائج لفهم أدائه وكيف يمكن تحسينه.
تقييم أداء النموذج:أولاً، افحص دقة النموذج، ثم استكشف المزيد من المقاييس الوصفية.
# Model Accuracy
print(f"Model Accuracy: {accuracy_score(y_test, y_pred):.2f}")
مصفوفة الارتباك:توفر مصفوفة الارتباك نظرة ثاقبة على التنبؤات الصحيحة والخاطئة لكل فئة.
cm = confusion_matrix(y_test, y_pred)
sns.heatmap(cm, annot=True, fmt="d", cmap="viridis", xticklabels=iris.target_names, yticklabels=iris.target_names)
plt.xlabel('Predicted')
plt.ylabel('Actual')
plt.title('Confusion Matrix')
plt.show()
تقرير التصنيف:يتضمن تقرير التصنيف مقاييس مثل الدقة والاستدعاء ودرجة F1 لكل فئة.
print(classification_report(y_test, y_pred, target_names=iris.target_names))
أهمية الميزات:إن فهم الميزات التي تؤثر بشكل كبير على قرارات النموذج الخاص بك يمكن أن يوفر رؤى حول مجموعة البيانات.
feature_importance = clf.feature_importances_
sns.barplot(x=feature_importance, y=iris.feature_names)
plt.title('Feature Importance')
plt.show()
تفسير النموذج
توفر درجة الدقة ومصفوفة الارتباك وتقرير التصنيف بشكل جماعي نظرة شاملة لأداء النموذج. تشير الدقة العالية إلى فعالية النموذج في تصنيف أنواع القزحية، في حين توضح مصفوفة الارتباك وتقرير التصنيف دقته واسترجاعه ودرجات f1 عبر الفئات.
يكشف مخطط أهمية الميزة عن خصائص زهور القزحية (مثل طول البتلة أو عرضها) التي تؤثر على قرارات تصنيف النموذج. تعتبر هذه الرؤية ذات قيمة لفهم عملية اتخاذ القرار في نموذج Random Forest وهندسة الميزات المستقبلية أو مساعي الاختيار.
من خلال تفسير هذه النتائج، يمكننا أن نستنتج أن مصنف Random Forest فعال للغاية لمجموعة البيانات هذه، مما يوفر أساسًا متينًا لمهام النمذجة التنبؤية. يمكن أن تؤدي تجربة مجموعات بيانات مختلفة أو تعديل المعلمات الفائقة إلى تحسين أداء النموذج أو قدرته على التكيف مع المشكلات المختلفة.
تفسير أشجار القرار الفردية داخل الغابة العشوائية
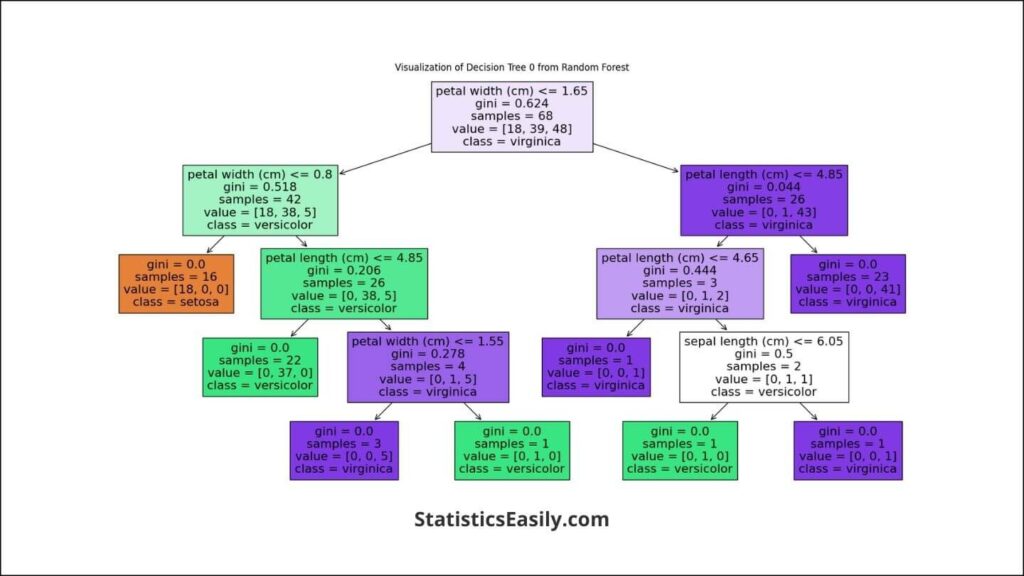
في حين أن الغابة العشوائية عبارة عن مجموعة من أشجار القرار، فإن كل شجرة تساهم في النتيجة. يمكن أن يوفر تصور الأشجار الفردية نظرة ثاقبة لعملية صنع القرار على مستوى أكثر تفصيلاً. دعونا نفحص إحدى هذه الأشجار من نموذج Random Forest الخاص بنا:
تصور شجرة القرار من الغابة العشوائية:
# Visualize the first decision tree from the Random Forest
tree_index = 0
plt.figure(figsize=(20,10))
plot_tree(clf.estimators_[tree_index],
          feature_names=iris.feature_names,
          class_names=iris.target_names,
          filled=True,
          rounded=True)
plt.title(f'Decision Tree Visualization: Tree {tree_index}')
plt.show()
يعرض هذا التصور كيف تقوم شجرة قرار واحدة داخل الغابة العشوائية بإجراء التصنيفات. يبدأ من الأعلى بعقدة جذر، ثم ينقسم إلى فروع وعقد قرار بناءً على قيم الميزات، وينتهي أخيرًا بالعقد الورقية التي تمثل تنبؤات الفصل.
تحليل هيكل الشجرة:
تمثل كل عقدة في الشجرة قرارًا يعتمد على قيمة ميزة معينة. على سبيل المثال، قد تقوم العقدة بتقسيم البيانات بناءً على طول أو عرض بتلة زهرة القزحية. تمثل الفروع نتيجة ذلك القرار، مما يؤدي إلى عقد قرار جديدة أو عقد ورقية. توفر العقد الطرفية تنبؤات الفئة النهائية عند استيفاء مجموعة من المعايير التي يحددها المسار من الجذر.
يشير عمق هذه الشجرة وتعقيدها إلى استراتيجية تصنيف النموذج. من الناحية العملية، تجمع Random Forest بين التنبؤات من العديد من هذه الأشجار لإجراء تصنيف نهائي أكثر دقة، وبالتالي الاستفادة من نقاط القوة في كل شجرة مع تعويض نقاط ضعفها.
يمكن أن يؤدي تضمين تصور شجرة القرار مثل الذي تم إنشاؤه أعلاه إلى إثراء مقالتك من خلال السماح للقراء بتصور العملية التنبؤية. إنه يزيل الغموض عن تشغيل النموذج ويقدم مثالًا ملموسًا لكيفية استفادة Random Forest من مسارات القرار المتعددة للوصول إلى قرار التصنيف.
تقييم النموذج الخاص بك
بعد تنفيذ نموذج Random Forest باستخدام لغة Python، فإن الخطوة الحاسمة التالية هي تقييم أدائه. يتضمن ذلك استخدام مقاييس محددة لفهم مدى نجاح النموذج في توقع النتائج على البيانات الجديدة غير المرئية. يغطي هذا القسم مقاييس التقييم الهامة ويقدم نصائح لتحسين النموذج وضبطه.
كيفية تقييم أداء نموذج الغابة العشوائي الخاص بك:
تعد مقاييس التقييم ضرورية لتقييم دقة وفعالية نموذج Random Forest الخاص بك. فيما يلي المقاييس الأكثر استخدامًا:
الدقة: هذا هو المقياس الأبسط، ويُحسب بقسمة عدد التنبؤات الصحيحة على إجمالي عدد التنبؤات. ورغم فائدتها، إلا أن الدقة وحدها قد تكون مضللة، خاصةً في مجموعات البيانات ذات الفئات غير المتوازنة.
الدقة والاستدعاء: تعتبر الدقة (نسبة النتائج الإيجابية الحقيقية في جميع التنبؤات الإيجابية) والاستدعاء (نسبة النتائج الإيجابية الحقيقية في جميع النتائج الإيجابية الفعلية) أمرًا بالغ الأهمية عندما تكون تكاليف النتائج الإيجابية الخاطئة والنتائج السلبية الخاطئة مرتفعة، على سبيل المثال، في التشخيص الطبي أو سيناريوهات الكشف عن الاحتيال.
F1 Score: هو المتوسط التوافقي للدقة والاستدعاء، ويُقدّم مقياسًا واحدًا لتقييم توازنهما. يصل مؤشر F1 إلى أفضل قيمة له عند 1 (دقة واستدعاء مثاليان) وإلى أسوأ قيمة له عند 0.
مصفوفة الارتباك: جدول يُستخدم لوصف أداء نموذج التصنيف على مجموعة بيانات اختبارية معروفة قيمها الحقيقية. يتيح لك هذا الجدول تصور تنبؤات النموذج، بما في ذلك النتائج الإيجابية الصحيحة، والنتائج الإيجابية الخاطئة، والنتائج السلبية الصحيحة، والنتائج السلبية الخاطئة.
تفسير النتائج:
يتيح لك فهم هذه المقاييس قياس أداء النموذج بدقة. على سبيل المثال، قد يبدو معدل الدقة العالي ممتازًا للوهلة الأولى. ومع ذلك، قد يكشف المزيد من الفحص من خلال الدقة والاستدعاء ودرجة F1 عن المجالات التي يواجه فيها النموذج صعوبات، مثل الفشل في التنبؤ بفئة معينة بدقة.
نصائح لتحسين النموذج وضبطه:
ضبط Hyperparameter: تحتوي نماذج الغابات العشوائية على العديد من المعلمات الفائقة، مثل عدد الأشجار (n_estimators) وعمق الأشجار (max_depth)، والتي يمكن أن تؤثر بشكل كبير على الأداء. يمكن أن يساعد استخدام البحث الشبكي أو البحث العشوائي في إيجاد التركيبة المثلى لهذه المعلمات الفائقة لمجموعة البيانات الخاصة بك.
اختيار الميزات: تتميز غابات الأشجار العشوائية بقدرتها على ترتيب أهمية الميزات بشكل تلقائي. ومن خلال تحليل الميزات الأقل أهمية واستبعادها، يمكنك تقليل تعقيد النموذج وتحسين أدائه.
التحقق المتبادل: يساعد تطبيق التحقق المتبادل، مثل التحقق المتبادل k-fold، على ضمان أن يكون أداء النموذج الخاص بك متسقًا عبر مجموعات فرعية مختلفة من مجموعة البيانات الخاصة بك، مما يزيد من قوة النموذج الخاص بك.
عنوان الاعلان
وصف الإعلان. لوريم إيبسوم دولور سيت أميت، consectetur adipiscing إيليت.
خاتمة
قدمت هذه المقالة دليلاً شاملاً لفهم Random Forest في Python وتطبيقها، حيث يغطي أسسها النظرية وإعداد البيانات والتنفيذ العملي وتقييم النموذج. بفضل قدرتها على التعامل مع مهام التصنيف والانحدار بفعالية، تظل Random Forest أداة قوية في ترسانة عالم البيانات، حيث توفر دقة عالية ومتانة ضد التجاوز. إن التشجيع على تجربة مجموعات بيانات مختلفة ومواجهة مشكلات النمذجة التنبؤية المختلفة يؤكد على تنوع Random Forest وقدرته على التكيف. من خلال اتباع الخطوات التفصيلية، بدءًا من إعداد بيئة Python وحتى تقييم أداء النموذج، يكون القراء مجهزين جيدًا للاستفادة من Random Forest في مشاريع علوم البيانات الخاصة بهم، مما يدفع حدود التحليلات التنبؤية.
مقالات مقترحة
اكتشف المزيد من الأفكار والبرامج التعليمية حول موضوعات علوم البيانات من خلال الاطلاع على مقالاتنا الأخرى.
- أشجار القرار: من النظرية إلى الممارسة في بيثون لعلماء البيانات الطموحين
- فهم أخذ العينات العشوائية: التقنيات الأساسية في تحليل البيانات
- أخذ العينات العشوائية في برنامج Excel: تحليل متعمق
- الانحدار اللوجستي باستخدام Scikit-Learn (قصة)
- توليد رقم عشوائي
الأسئلة الشائعة (FAQs)
س1: ما هي الغابة العشوائية؟إنها طريقة متعددة الاستخدامات للتعلم الآلي قادرة على أداء مهام الانحدار والتصنيف، باستخدام أشجار قرار متعددة ومتوسط تنبؤاتها لتحسين الدقة والتحكم في التجاوز.
س2: كيف تعمل الغابة العشوائية؟تقوم الغابة العشوائية بإنشاء "غابة" من أشجار القرار العشوائية لجعل تنبؤاتها أكثر دقة من أي شجرة قرار واحدة عن طريق حساب متوسط النتائج أو استخدام التصويت بالأغلبية.
س3: لماذا يُفضل استخدام خوارزمية الغابة العشوائية على الخوارزميات الأخرى؟يُفضل استخدامها نظرًا لتعدد استخداماتها، وقدرتها على التعامل مع مجموعات البيانات الكبيرة ذات الأبعاد العالية، وقدرتها على إدارة القيم المفقودة، مما يجعلها قوية ضد التجاوز.
س4: ما هي التطبيقات الرئيسية للغابة العشوائية؟يتم استخدامها على نطاق واسع في مجالات مختلفة، مثل الخدمات المصرفية والطب وسوق الأوراق المالية والتجارة الإلكترونية، للكشف عن الاحتيال والتنبؤ بالأمراض والتنبؤ بأسعار الأسهم وتجزئة العملاء.
س5: كيف تقوم بإعداد البيانات لـ Random Forest؟يتضمن إعداد البيانات التنظيف، ومعالجة القيم المفقودة، وتشفير المتغيرات الفئوية، وتقسيم مجموعة البيانات إلى مجموعات تدريب واختبار.
س6: ما هي المعلمات الفائقة في نموذج الغابة العشوائية، وكيف تؤثر على النموذج؟تؤثر المعلمات الفائقة على تعقيد النموذج وأدائه، مثل عدد الأشجار وعمقها والحد الأدنى لتقسيم العينات. ويمكن أن يؤدي ضبط هذه المعلمات إلى تحسين الدقة بشكل ملحوظ.
س7: كيف يمكنك تقييم فعالية نموذج الغابة العشوائية؟تشمل مقاييس التقييم القياسية الدقة، والضبط، والاستدعاء، ودرجة F1، ومصفوفة الارتباك، والتي تساعد في تقييم الأداء التنبؤي للنموذج ودقته.
س8: ما هي بعض التحديات في استخدام الغابات العشوائية؟على الرغم من قوتها، إلا أن الغابات العشوائية يمكن أن تكون كثيفة الحساب ويصعب تفسيرها مقارنة بالنماذج الأبسط، ويمكن أن يكون أداؤها حساسًا للبيانات المشوشة.
س9: كيف يمكنك ضبط نموذج الغابة العشوائية لتحسين الأداء؟يتضمن ضبط النموذج تعديل المعلمات الفائقة مثل عدد الأشجار، والعمق الأقصى، والحد الأدنى لتقسيم العينات من خلال تقنيات البحث الشبكي أو العشوائي للعثور على الإعدادات المثلى.
س10: هل يمكن لخوارزمية الغابة العشوائية التعامل مع البيانات الفئوية والرقمية؟نعم، يمكن لخوارزمية الغابة العشوائية التعامل مع مزيج من البيانات الفئوية والرقمية. فهي تستخدم تقنيات مثل الترميز الأحادي الساخن للمتغيرات الفئوية لجعل البيانات مناسبة للنمذجة.