تحليل المكونات الرئيسية: تحويل البيانات إلى رؤى صادقة
سوف تتعلم قوة تحليل المكونات الرئيسية في الكشف عن حقائق البيانات المخفية.
المقدمة
تحليل المكون الرئيسي (PCA)تقنية أساسية في الإحصاء وعلوم البيانات، إذ يُقدم أسلوبًا متطورًا لتقليل أبعاد مجموعات البيانات الضخمة مع الحفاظ على أكبر قدر ممكن من تنوعها. تُبسط هذه العملية التعقيد الكامن في البيانات متعددة الأبعاد، وتُحسّن قابلية تفسيرها دون المساس بسلامة البيانات الأصلية. يسعى تحليل المكونات الرئيسية، في جوهره، إلى تحديد الأنماط في البيانات، وتسليط الضوء على التناقضات، وتحويل مجموعات البيانات المعقدة إلى شكل أكثر وضوحًا، مما يُمكّن المحللين والعلماء من استخلاص رؤى قيّمة بكفاءة أكبر. تهدف هذه المقالة إلى تبسيط تحليلPCA، وإرشاد القراء عبر أسسه المفاهيمية، وتطبيقاته العملية، وتأثيره العميق على استراتيجيات تحليل البيانات . من خلال التركيز علىPCA، نسعى إلى توضيح الطريق للمهتمين والمهنيين، وتعزيز فهم أعمق وإتقان لهذه الأداة التحليلية التي لا غنى عنها.
إضاءات
- يقلل PCA من أبعاد البيانات مع الحفاظ على الخصائص الأساسية للبيانات.
- تاريخيًا، تطورت PCA من مفاهيم بسيطة إلى تطبيقات معقدة في علم الجينوم والتمويل.
- يمكن أن يؤدي استخدام PCA بشكل صحيح إلى الكشف عن أنماط في البيانات لم تكن واضحة في البداية.
- يعد اختيار العدد الصحيح من المكونات في PCA أمرًا بالغ الأهمية لتفسير البيانات بدقة.
- تعمل أدوات وبرامج PCA على تبسيط التحليل، مما يجعل الوصول إلى رؤى البيانات أكثر سهولة.
عنوان الاعلان
وصف الإعلان. لوريم إيبسوم دولور سيت أميت، consectetur adipiscing إيليت.
جوهر تحليل المكونات الرئيسية
تحليل المكون الرئيسي (PCA)هو إجراء إحصائي يستخدم تحويلًا متعامدًا لتحويل مجموعة من المشاهدات لمتغيرات قد تكون مترابطة إلى قيم لمتغيرات غير مترابطة خطيًا تُسمى المكونات الرئيسية. تُعرف هذه التقنية على نطاق واسع بقدرتها على تقليل أبعاد البيانات مع الحفاظ على معظم التباين فيها. يكمن جوهر تحليل المكونات الرئيسية في قدرته على استخلاص المعلومات الأساسية من جدول البيانات، وضغط حجم مجموعة البيانات، وتبسيط وصفها مع الحفاظ على أهم أجزاء جميع المتغيرات.
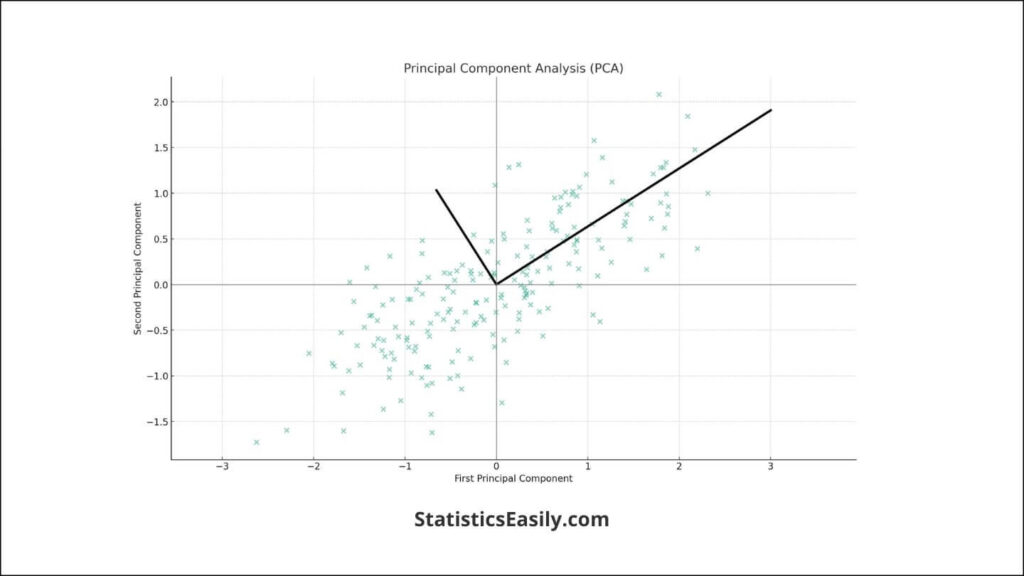
تتضمن المبادئ الأساسية لـ PCA تحديد الاتجاهات أو المحاور التي يتم من خلالها تعظيم التباين في البيانات. المكون الرئيسي الأول هو الاتجاه الذي يزيد من تباين البيانات. المكون الرئيسي الثاني متعامد مع الأول. فهو يحدد اتجاه التباين الأعلى التالي، وما إلى ذلك. تتيح هذه العملية لـ PCA تقليل مجموعات البيانات المعقدة إلى بُعد أقل، مما يسهل تحليل البيانات وتصورها دون فقدان كبير للمعلومات.
إن جمال PCA في تبسيط مجموعات البيانات المعقدة مع الاحتفاظ بالمعلومات الأساسية لا مثيل له. فهو يمكّن علماء البيانات والإحصائيين من الكشف عن الأنماط المخفية في البيانات، مما يسهل اتخاذ قرارات أكثر استنارة. من خلال التركيز على المكونات الأكثر أهمية، يساعد PCA في تسليط الضوء على البنية الأساسية للبيانات، وبالتالي توفير رؤية أوضح للطبيعة الحقيقية للبيانات التي يتم تحليلها. هذه الطريقة تعزز كفاءة تحليل البيانات. فهو يساهم في فهم أكثر صدقًا وعمقًا للخصائص الجوهرية للبيانات.
الخلفية التاريخية والأسس النظرية
رحلةتحليل المكون الرئيسي (PCA)إلى أوائل القرن العشرين، حيث انطلقت من العمل الرائد كارل بيرسون عام ١٩٠١. سعى بيرسون، في إطار سعيه لفهم بنية البيانات الأساسية، إلى تطوير تحليل المكونات الرئيسية لوصف التباين الملحوظ في فضاء بيانات متعدد الأبعاد من خلال متغيرات غير مترابطة. وفي وقت لاحق، قام هارولد هوتلينج بصياغة هذه التقنية رياضياً في ثلاثينيات القرن العشرين، مما وفر أساساً إحصائياً أكثر متانة ووسع نطاق تطبيقها ليشمل مجالات علمية متنوعة.
تتشابك الأسس الرياضية لـ PCA بعمق مع الجبر الخطي، وخاصة مفاهيم المتجهات الذاتية والقيم الذاتية. في جوهره، يقوم PCA بتحويل البيانات الأصلية إلى نظام إحداثيات جديد حيث تقع الفروق الأكثر أهمية في أي إسقاط للبيانات على الإحداثيات الأولى، المعروفة بالمكونات الرئيسية. يتم تحقيق هذا التحول من خلال التحلل الذاتي لمصفوفة التباين المشترك للبيانات أو تحليل القيمة المفرد (SVD) لمصفوفة البيانات. تضمن هذه الطرق تعظيم التباين والحفاظ على السلامة الهيكلية لمجموعة البيانات.
تكمن دقة وصدق PCA في صرامة الرياضيات. يقوم PCA بتغليف التباين المتأصل في البيانات والعلاقات بين المتغيرات باستخدام مصفوفة التباين المشترك، مما يوفر عرضًا مقطرًا يسلط الضوء على الأنماط الأكثر أهمية. لا تعمل هذه العملية على تبسيط تعقيد البيانات فحسب، بل تضع أيضًا الحقيقة الأساسية - البنية الأساسية للبيانات وتنوعها - في المقدمة، مما يسمح بالتحليل الثاقب واتخاذ القرار.
لقد أثبتت PCA نفسها باعتبارها حجر الزاوية في تحليل البيانات الإحصائية من خلال تطويرها وأسسها الرياضية. لقد جعلت قدرتها على تقليل الأبعاد مع الحفاظ على المعلومات الأساسية منها أداة لا تقدر بثمن لعلماء البيانات والإحصائيين، مما يسهل فهمًا أعمق للبيانات عبر العديد من المجالات.
تطبيقات عملية لتحليل المكونات الرئيسية
تحليل المكون الرئيسي (PCA)أصوله الأكاديمية ليصبح أداة تحليلية أساسية في مجالات متعددة. وقد أحدثت قدرته على استخلاص رؤى سهلة الفهم من مجموعات البيانات الضخمة ثورة في كيفية تفسيرنا للمعلومات المعقدة، مما جعله ذا قيمة لا تقدر بثمن في مجالات متنوعة مثل علم الجينوم والتمويل ومعالجة الصور الرقمية.
فيعلم الجينوم، تعمل تقنية تحليل المكونات الرئيسية (PCA) على تبسيط البيانات الجينية، التي غالباً ما تتضمن آلاف المتغيرات. ومن خلال تقليل الأبعاد، تُمكّن هذه التقنية الباحثين من تحديد المؤشرات والأنماط الجينية المرتبطة بالأمراض بكفاءة أكبر، مما يُسهّل تحقيق إنجازات في الطب الشخصي والدراسات التطورية.
The يستفيد القطاع الماليمن تحليل المكونات الرئيسية (PCA) لإدارة المخاطر ووضع استراتيجيات الاستثمار. إذ يُمكن لتحليل المكونات الرئيسية تسليط الضوء على العوامل الأساسية المؤثرة في تقلبات السوق من خلال تحليل مصفوفة التباين المشترك لعوائد الأصول. ويُسهم هذا التبسيط في تنويع المحفظة الاستثمارية، مُبرزًا الاتجاهات الكامنة التي قد لا تظهر من خلال التحليل التقليدي.
فيضغط الصور، يقلل تحليل المكونات الرئيسية (PCA) من التكرار في بيانات البكسل، مما يتيح تخزين الصور ونقلها بكفاءة دون فقدان كبير في الجودة. يُعد هذا التطبيق بالغ الأهمية في المجالات التي يكون فيها عرض النطاق الترددي محدودًا، مثل صور الأقمار الصناعية والتطبيب عن بُعد، ومن الضروري تحقيق التوازن بين الضغط والحفاظ على سلامة الصورة.
يكشف PCA عن الأنماط الأساسية في البيانات من خلال هذه التطبيقات ويبسط عمليات صنع القرار بشكل كبير. ومن خلال استخلاص مجموعات البيانات المعقدة إلى مكوناتها الأكثر أهمية، يعكس PCA الجودة المتأصلة في تحليل البيانات - مما يحول أحجام البيانات الهائلة إلى رؤى قابلة للتنفيذ. ويعزز هذا الانتقال من التعقيد إلى الوضوح فهمنا للبيانات. فهو يسمح لنا باتخاذ قرارات مستنيرة عبر مجموعة من المجالات المهمة، مما يعرض تنوع PCA وأهميته الدائمة.
دليل خطوة بخطوة لإجراء تحليل المكونات الرئيسية في بايثون
يؤدي إجراء تحليل المكونات الرئيسية (PCA) في Python إلى تكثيف مجموعات البيانات الكبيرة بكفاءة في مكوناتها الأكثر أهمية، مما يؤدي إلى تبسيط تحليل البيانات. يستعرض هذا الدليل العملية بدءًا من إعداد البيانات وحتى تفسيرها، وذلك باستخدام مكتبة scikit-Learn، المشهورة بأدواتها القوية لاستخراج البيانات وتحليلها.
1. تحضير البيانات
قبل تنفيذ PCA، تأكد من أن بياناتك مناسبة لهذه العملية. وهذا يعني التعامل مع القيم المفقودة، وتطبيع البيانات، وتقليل الميزات إذا كانت مترابطة بشكل كبير.
import pandas as pd
from sklearn.preprocessing import StandardScaler

# Load dataset
df = pd.read_csv('data_pca.csv')

# Preprocessing
## Handle missing values if any
df.fillna(method='ffill', inplace=True)

## Feature scaling
features = ['Feature1', 'Feature2', 'Feature3', 'Feature4', 'Feature5', 'Feature6']
x = df.loc[:, features].values
x = StandardScaler().fit_transform(x)  # Normalize data
2. تنفيذ اتفاقية التعاون والتنسيق
مع البيانات المعدة، يمكنك تطبيق PCA. حدد عدد المكونات الرئيسية التي ترغب في الاحتفاظ بها أو اسمح للخوارزمية بالاختيار بناءً على التباين.
from sklearn.decomposition import PCA

# PCA transformation
pca = PCA(n_components=2)  # n_components to specify desired reduction
principalComponents = pca.fit_transform(x)

# Convert to a DataFrame
principalDf = pd.DataFrame(data=principalComponents, columns=['Principal Component 1', 'Principal Component 2'])
3. تحليل النتائج
بعد تحويل البيانات، قم بتحليل المكونات الرئيسية لفهم البنية الأساسية لمجموعة البيانات.
print(pca.explained_variance_ratio_)
يؤدي هذا إلى طباعة التباين الموضح بواسطة كل مكون من المكونات الرئيسية المحددة، مما يعطي فكرة عن مقدار المعلومات التي يتم التقاطها بواسطة التحليل.
4. تصور
يمكن أن يوفر تصور المكونات الرئيسية رؤى بديهية حول بنية البيانات والتجميع.
import matplotlib.pyplot as plt

plt.figure(figsize=(8,6))
plt.scatter(principalDf['Principal Component 1'], principalDf['Principal Component 2'])
plt.xlabel('Principal Component 1')
plt.ylabel('Principal Component 2')
plt.title('PCA on Dataset')
plt.show()
5. ترجمة
يتضمن التفسير فهم المكونات الرئيسية من حيث الميزات الأصلية. يتطلب هذا غالبًا معرفة بالمجال وإلقاء نظرة على أوزان مكونات PCA.
# Accessing the components_
print(abs(pca.components_))
يوضح هذا وزن كل ميزة أصلية في المكونات الرئيسية، مما يساعد في تفسير المكونات.
نتائج مجموعة البيانات سبيل المثال
باستخدام مجموعة بيانات افتراضية، قد يكشف PCA أن المكونين الرئيسيين الأولين يلتقطان جزءًا كبيرًا من التباين في البيانات. قد يُظهر التمثيل المرئي مجموعات واضحة، مما يقترح مجموعات متميزة داخل مجموعة البيانات. يمكن أن تشير أوزان المكونات إلى الميزات الأكثر تأثيرًا على هذه المجموعات.
دليل خطوة بخطوة لإجراء تحليل المكونات الرئيسية على R
يُسهّل إجراء تحليل المكونات الرئيسية (PCA) في R عملية اختزال مجموعات البيانات الكبيرة إلى مكوناتها الأكثر أهمية، مما يُبسّط تحليل البيانات. يشرح هذا الدليل العملية خطوة بخطوة، بدءًا من إعداد البيانات وصولًا إلى تفسيرها، مستخدمًا مجموعة الأدوات المتنوعة والشاملة المتاحة في R للحسابات الإحصائية.
1. تحضير البيانات
قبل تنفيذ PCA، تأكد من أن بياناتك مناسبة لهذه العملية. يتضمن ذلك معالجة القيم المفقودة وتوحيد البيانات وتقليل الميزات إذا كانت شديدة الارتباط.
# Load dataset
df <- read.csv('data_pca.csv')

# Preprocessing
## Handle missing values if any
df[is.na(df)] <- method = na.omit(df)

## Feature scaling
features <- df[, c('Feature1', 'Feature2', 'Feature3', 'Feature4', 'Feature5', 'Feature6')]
scaled_features <- scale(features) # Normalize data
2. تنفيذ اتفاقية التعاون والتنسيق
مع البيانات المعدة، يمكن تطبيق PCA. يمكنك تحديد عدد المكونات الرئيسية التي ترغب في الاحتفاظ بها أو السماح للخوارزمية بالاختيار بناءً على التباين الموضح.
# PCA transformation
pca <- prcomp(scaled_features, rank. = 2, center = TRUE, scale. = TRUE)

# The rank. argument specifies the desired reduction
# prcomp automatically centers and scales the variables
3. تحليل النتائج
بعد تحويل البيانات، يمكن استخدام ملخص كائن PCA لفهم التباين الموضح بواسطة المكونات الرئيسية.
# This prints the summary of the PCA object
summary(pca)
4. تصور
يمكن أن يوفر تصور المكونات الرئيسية رؤى بديهية حول بنية البيانات والتجميع المحتمل.
# This creates a scatter plot of the first two principal components
plot(pca$x[, 1:2], col = df$YourGroupVariable, xlab = 'Principal Component 1', ylab = 'Principal Component 2', main = 'PCA on Dataset')
5. ترجمة
يتضمن تفسير PCA فهم كيفية مساهمة الميزات الأصلية في المكونات الرئيسية، والتي تتطلب غالبًا معرفة بالمجال.
# This shows the loading of each original feature on the principal components
pca$rotation
نتائج مجموعة البيانات سبيل المثال
باستخدام مجموعة بيانات افتراضية، قد يكشف PCA في R أن المكونين الرئيسيين الأولين يلتقطان جزءًا كبيرًا من التباين في البيانات. قد يُظهر التمثيل المرئي مجموعات واضحة، مما يشير إلى مجموعات متميزة داخل مجموعة البيانات. يمكن أن يشير فحص التدوير (التحميلات) إلى الميزات الأكثر تأثيرًا على هذه المجموعات.
أفضل الممارسات والمزالق الشائعة
يعد الالتزام بأفضل الممارسات واليقظة بشأن المخاطر الشائعة أمرًا بالغ الأهمية لتفسير البيانات ذات المعنى من خلال تحليل المكونات الرئيسية (PCA). تعد الدقة والتمثيل الحقيقي لجوهر مجموعة البيانات أمرًا ضروريًا.
ضمان الدقة
- توحيد البيانات: قم دائمًا بتوحيد بياناتك قبل تطبيق PCA، حيث أن التحليل حساس لتباين المتغيرات الأولية.
- قيم مفقودة: قم بمعالجة أي قيم مفقودة أو لا نهائية في مجموعة البيانات لمنع التحيزات في استخراج المكون.
- القيم المتطرفة: التحقيق في القيم المتطرفة وفهمها قبل PCA، لأنها يمكن أن تؤثر بشكل غير متناسب على النتائج.
تجنب التفسيرات الخاطئة
- تفسير المكونات: المكونات الرئيسية هي بنيات رياضية قد لا يكون لها دائمًا تفسير مباشر في العالم الحقيقي. احرص على عدم المبالغة في تفسيرها.
- الفروق: لا تضمن نسبة التباين العالية للمكونات القليلة الأولى أنها تحتوي على جميع المعلومات المفيدة. قد توجد تفاصيل دقيقة مهمة في المكونات ذات التباين الأقل.
اختيار العدد الصحيح من المكونات
- وأوضح التباين: استخدم مخططًا حصيًا أو نسبة التباين الموضحة التراكمية لتحديد نقطة الكوع أو عدد المكونات التي تلتقط معلومات جوهرية.
- البخل: تحقيق التوازن بين التعقيد وقابلية التفسير، واختيار أقل عدد من المكونات التي لا تزال توفر رؤية شاملة لبنية البيانات.
- معرفة المجال: استفد من فهم مجال عملك لتحديد عدد المكونات التي يجب الاحتفاظ بها، والتأكد من أنها منطقية لسياقك المحدد.
البقاء وفيا لجوهر البيانات
- الاتساق مع الأهداف: قم بمواءمة عدد المكونات التي تم الاحتفاظ بها مع الأهداف التحليلية، سواء كانت تبسيط البيانات، أو تقليل الضوضاء، أو الكشف عن الهياكل الكامنة.
- مراجعة شاملة: الجمع بين PCA وتقنيات استكشاف البيانات الأخرى لبناء فهم شامل للبيانات.
سيؤدي اتباع هذه الإرشادات إلى توجيه PCA الخاص بك نحو تحليل موثوق، والحفاظ على سلامة البيانات مع استخلاص رؤى قابلة للتنفيذ. من خلال البقاء حذرًا من التعقيدات التي ينطوي عليها تحليل PCA، يمكن للمرء تجنب المزالق التي تؤدي إلى سوء التفسير والتأكد من أن التحليل يظل انعكاسًا حقيقيًا لمجموعة البيانات الأساسية.
موضوعات متقدمة في تحليل المكونات الرئيسية
مع استمرار توسع مشهد البيانات وتنوعه، يتطور تحليل المكونات الرئيسية (PCA)، محتضنًا جذوره الكلاسيكية وتوسعاته المبتكرة لمعالجة تعقيد هياكل البيانات الحديثة. تكشف هذه الرحلة إلى موضوعات PCA المتقدمة عن تنوع الطريقة والقدرة على التكيف الدائم في علم البيانات.
الاختلافات في PCA
- نواة PCA: يتم استخدام هذا الامتداد لـ PCA لتقليل الأبعاد غير الخطية. يؤدي استخدام أساليب kernel إلى التقاط بنية البيانات بشكل فعال حيث لا تكون العلاقة بين المتغيرات خطية، وبالتالي الكشف عن الأنماط التي قد تفوتها PCA التقليدية.
- PCA متناثر: في مجموعات البيانات حيث يفوق عدد الميزات عدد الملاحظات، يتألق Sparse PCA من خلال إنتاج المكونات الرئيسية مع عمليات تحميل متفرقة. وينتج عن ذلك نموذج أكثر قابلية للتفسير، ويسلط الضوء على مجموعة فرعية أصغر من الميزات، وهو أمر مفيد بشكل خاص في سيناريوهات البيانات عالية الأبعاد مثل علم الجينوم.
ملحقات PCA
- PCA التزايدي: بالنسبة لمجموعات البيانات الضخمة التي لا يمكن احتواؤها في الذاكرة، يقدم Incremental PCA حلاً. فهو يقوم بتقسيم حساب PCA إلى دفعات صغيرة يمكن التحكم فيها، وتحديث المكونات بشكل تدريجي، وهو أمر مفيد أيضًا لتدفق البيانات.
- PCA قوي: يمكن أن تؤثر القيم المتطرفة بشكل كبير على نتائج PCA. يعمل PCA القوي على تخفيف ذلك عن طريق فصل القيم المتطرفة المتناثرة عن البنية ذات الرتبة المنخفضة، مما يضمن عدم تحريف النقاط الشاذة للبيانات الأساسية.
عنوان الاعلان
وصف الإعلان. لوريم إيبسوم دولور سيت أميت، consectetur adipiscing إيليت.
خاتمة
لقد تم تأسيس تحليل المكونات الرئيسية (PCA) بقوة كتقنية لا غنى عنها في صندوق أدوات تحليل البيانات. فهو يسهل فهمًا أعمق للبيانات عن طريق استخلاص عناصرها الأكثر إفادة. وقد سعى هذا الدليل إلى توضيح منهجية PCA، بدءًا من الرياضيات التأسيسية وحتى تطبيقها في مختلف المجالات. لقد أكدنا على فائدتها في تقليل الأبعاد مع الحفاظ على البنية المتأصلة للبيانات. تساعد هذه العملية بشكل كبير في كل من التصور والتحليلات اللاحقة. يتم تشجيع الباحثين وعلماء البيانات على دمج PCA في سير عملهم لتعزيز إمكانية تفسير مجموعات البيانات المعقدة. عند تنفيذها بشكل مدروس، توفر PCA رؤى ثاقبة للأنماط السائدة داخل البيانات وتبسط المسار نحو اتخاذ قرارات أكثر قوة واستنارة.
مقالات مقترحة
استكشف مكتبة مدونتنا الغنية بالمقالات حول الموضوعات ذات الصلة لاكتشاف المزيد حول تحليل البيانات.
- تقنية ريتشارد فاينمان: طريق لتعلم أي شيء في تحليل البيانات
- فهم توزيعات النماذج الخطية المعممة
- هل يمكن للانحرافات المعيارية أن تكون سلبية؟ (قصة)
- Box Plot: أداة قوية لتصور البيانات
- النماذج الخطية المعممة (قصة)
الأسئلة الشائعة (FAQs)
PCA هو إجراء كمي مصمم للتأكيد على التباين واستخراج أنماط مهمة من مجموعة البيانات، وتحديد المحاور الرئيسية للتباين بشكل فعال.
تلعب PCA دورًا حاسمًا في تبسيط مجموعات البيانات عالية الأبعاد من خلال الاحتفاظ بالاتجاهات والأنماط الأساسية، وبالتالي تعزيز إمكانية التفسير دون فقدان كبير للمعلومات.
يعمل PCA عن طريق حساب المكونات الرئيسية التي تعمل على زيادة التباين داخل مجموعة البيانات، وتحويل البيانات إلى نظام إحداثي جديد بهذه المحاور الرئيسية.
في الواقع، يعد PCA أداة قيمة للنماذج التنبؤية لأنه يقلل من الأبعاد، وبالتالي تحسين أداء النموذج عن طريق تصفية الضوضاء والمعلومات الأقل صلة.
يستخدم PCA على نطاق واسع في مختلف المجالات التحليلية، بما في ذلك التمويل والإحصاء الحيوي والعلوم الاجتماعية، حيث يساعد في تشريح وفهم البيانات المعقدة.
يجب أن يتماشى اختيار المكونات في PCA مع مقدار التباين الموضح، والذي يتم تقييمه عادةً من خلال مخططات حصاة أو تباين تراكمي، ومتوازن مع إمكانية تفسير البيانات.
قد يكون PCA أقل فعالية مع مجموعات البيانات حيث تكون العلاقات بين المتغيرات غير خطية وحساسة لقياس البيانات.
PCA هو الأمثل للبيانات الرقمية المستمرة. تعد خطوات المعالجة المسبقة المحددة ضرورية للبيانات الفئوية لضمان التطبيق الدقيق لتقنيات PCA.
يساعد PCA في إخفاء هوية البيانات عن طريق تحويل المتغيرات الأصلية إلى مكونات رئيسية، مما يزيد من تعقيد عملية التحديد المباشر للسجلات الفردية.
تتوفر مكتبات PCA بسهولة في بيئات برمجية مثل R وPython، ولا سيما ضمن حزم مثل scikit-learn، والتي توفر أدوات شاملة لتنفيذ PCA.