


ميزة لغة SQL في استعلامات البيانات
يوضح هذا الدليل لمحللي البيانات والعلماء كيف يمكن للمبادئ الأساسية للغة SQL أن تبني خطوط بيانات أسرع وأكثر قوة وأكثر قابلية للصيانة من البرامج النصية العامة للغة بايثون.
مقدمة: التكلفة الخفية لـ "مجرد المرور عبرها"
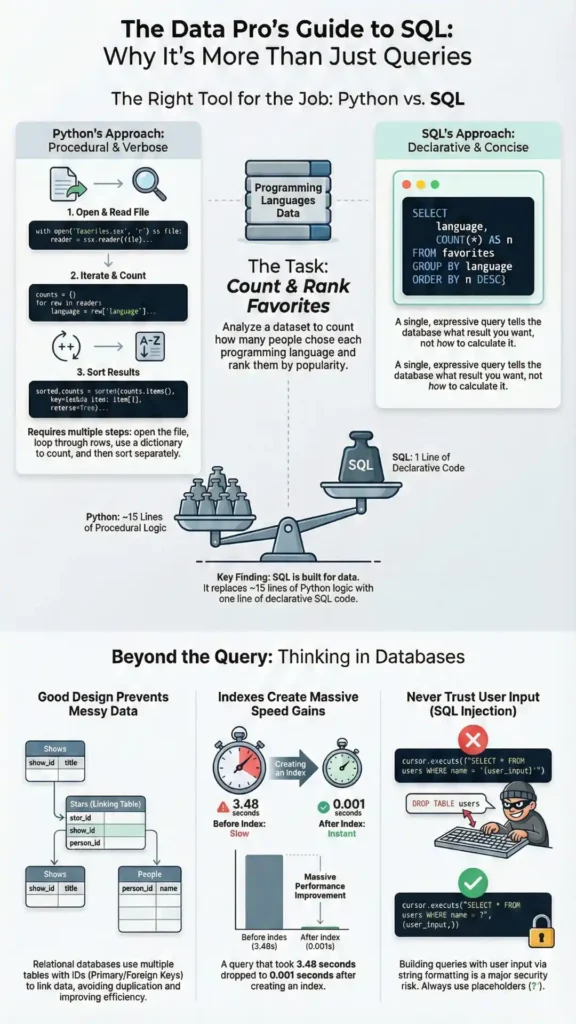
بالنسبة للعديد من ممارسي تحليل البيانات، يتمثل النهج الافتراضي للتعامل مع ملف CSV جديد في كتابة برنامج بايثون. نفتح الملف، ونمر على صفوفه، وننشئ عدادات أو قوائم يدويًا للإجابة على ما يبدو أسئلة بسيطة. مع أن هذه الطريقة فعّالة، إلا أنها غالبًا ما تؤدي إلى كود بطيء وهش يصعب صيانته. قد يؤدي تغيير ترتيب بعض الأعمدة في الملف الأصلي إلى تعطيل البرنامج بأكمله. كما أن الإجابة على سؤال مختلف قليلًا تتطلب إعادة كتابة حلقات وشروط معقدة. يخفي هذا النهج الإجرائي، خطوة بخطوة، طريقةً أكثر قوةً وأناقةً وكفاءةً للتعامل مع البيانات. من خلال اعتماد لغة متخصصة، يمكننا التعبير عن الأسئلة المعقدة بسهولة أكبر، واستبدال 17 سطرًا من بايثون الهشة بسطر واحد واضح من لغة SQL.
الخلاصة الأولى: اجعل عملية استيعاب البيانات لديك قوية
من أكثر الثغرات الأمنية شيوعًا في برامج بايثون البسيطة لمعالجة البيانات هي الوصول إلى أعمدة ملفات CSV باستخدام فهرسها الرقمي، مثل row[1]. This code is fragile because it makes a hard-coded assumption about the data’s structure. If a colleague opens the source spreadsheet and moves the second column to the third position, the script will either crash or, worse, silently produce incorrect results by processing the wrong data.
الحل الأكثر فعالية هو استخدام الميزات المدمجة في بايثون csv.DictReader. Instead of treating each row as a list of values, DictReader treats it as a dictionary where the keys are the column headers from the first row of the file. This allows you to access data by its meaningful name (e.g., row['language']), not its arbitrary position. The code will now work correctly even if the columns are reordered, as long as the header names remain the same.
اتصال علم البيانات: تجعل هذه الممارسة مسارات استيعاب البيانات أكثر مرونة بشكل ملحوظ في مواجهة التغييرات في ملفات المصدر. فهي تقلل من الأخطاء غير المتوقعة، وتقلل من الصيانة، وتضمن أن تستند نتائج التحليل إلى أعمدة البيانات الصحيحة، مما يحسن موثوقية سير العمل بأكمله.
الخلاصة الثانية: التحول في التفكير التصريحي
يتمثل أحد الفروق الأساسية بين لغة بايثون ولغة SQL في نموذج البرمجة الذي تشجعه كل منهما. بايثون هي في الأساس صيغة الامر—أخبر الكمبيوتر كيف للحصول على إجابة خطوة بخطوة. لحساب عدد لغات البرمجة المفضلة من ملف CSV، تتضمن طريقة بايثون تهيئة متغيرات العداد، وفتح الملف، والتكرار عبر كل صف، واستخدام if/elif statements to increment the correct counter. This process, which can take around 17 lines of code, is verbose and details a specific procedure.
أما لغة SQL، على النقيض من ذلك، فهي إعلاني—أنت تُعلن ماذا الإجابة التي تريدها، وسيقوم محرك قاعدة البيانات بتحديد الطريقة الأكثر كفاءة للحصول عليها. أما في لغة SQL، فإن نفس عملية العد تُنفذ بعبارة واحدة: SELECT language, COUNT(*) FROM favorites GROUP BY language;. This query doesn’t specify loops or conditionals; it simply states the desired result: a count of entries for each language. This shift from describing a process to describing an outcome is a powerful mental leap.
اتصال علم البيانات: يُمكّن التفكير التصريحي المحللين من التعبير عن أسئلة البيانات المعقدة بشكل مباشر وبأقل قدر من الأخطاء المنطقية. فبدلاً من بناء حلقات إجرائية معقدة، يمكنك التركيز على تحديد البيانات التي تحتاجها، مما يؤدي إلى استعلامات أنظف وأكثر وضوحًا ودقة.
«...يبدو أننا نقضي وقتًا طويلًا في بناء هذا، بينما سيكون من الأفضل لو استطعنا تبسيط هذا الكود... سيكون من الرائع أن نتمكن من الإجابة على ذلك بسرعة فائقة...» — محاضرة: SQL، جامعة هارفارد، CS50x 2025 (يوتيوب)
الخلاصة الثالثة: شكل البيانات الجيد ليس من قبيل الصدفة
تؤثر بنية بياناتك بشكل كبير على قدرتك على تحليلها بشكل صحيح وفعال. ومن الأخطاء الشائعة، كما يتضح من جدول بيانات مسلسل "ذا أوفيس"، تخزين البيانات ذات الصلة بشكل سيئ. أحد التصاميم السيئة يتضمن إضافة عمود جديد لكل نجم (star1, star2, etc.), which is inflexible and doesn’t scale. Another flawed approach is to have a row for each star, repeating the show’s title (“The Office”) over and over again, creating massive data redundancy.
الحل هو مفهوم أساسي لقاعدة البيانات يسمى التطبيعبدلاً من جدول واحد غير منظم، يمكنك تقسيم البيانات إلى جداول منفصلة لكل كيان. على سبيل المثال، يمكنك إنشاء shows table for TV shows and a people table for actors. You then create a third “join table,” stars, that links them together using their unique IDs (show_id و person_id).
يُزيل هذا التصميم التكرار عن طريق استبدال سلاسل نصية طويلة متغيرة الطول، مثل "The Office"، بأعداد صحيحة صغيرة ثابتة الحجم (مثل مُعرّف 32 بت أو 64 بت). يوفر هذا الأسلوب مساحة كبيرة ويُحسّن الأداء.
اتصال علم البيانات: يوفر التطبيع نموذجًا ذهنيًا قويًا لتنظيف البيانات وهيكلتها. يساعد التعرف على التكرار ومعالجته في مجموعات البيانات غير المنظمة (مثل جداول البيانات) على منع الأخطاء التحليلية ويضمن أن عمليات التجميع والربط تُنتج نتائج صحيحة. إنها خطوة أساسية في إعداد البيانات لتحليل موثوق.
الخلاصة الرابعة: حل الأداء في سطر واحد
تُعدّ الاستعلامات البطيئة عائقًا رئيسيًا في تحليل البيانات، لا سيما مع مجموعات البيانات الكبيرة ذات العلاقات المعقدة. فعلى سبيل المثال، استغرق استعلامٌ يربط ثلاثة جداول للعثور على جميع برامج ستيف كاريل التلفزيونية مدةً طويلةً للغاية بلغت 3.483 ثانية أثناء المحاضرة. ويعود هذا التأخير إلى أن قاعدة البيانات، دون توجيه، تُجري بحثًا خطيًا، حيث تفحص كل صف في الجدول للعثور على التطابقات.
الحل هو إنشاء INDEX on the column being searched. An index is a special data structure, much like the index at the back of a book, that allows the database to find specific rows almost instantly without scanning the entire table. By running a command like CREATE INDEX name_index ON people (name), you instruct the database to build an efficient lookup structure (typically a B-tree). In the lecture’s example, creating two indexes reduced a query for Steve Carell’s shows from 0.215 seconds to just 0.001 seconds—a massive performance gain.
المقابل هو أن الفهارس تستهلك مساحة تخزين أكبر وقد تبطئ عمليات الكتابة قليلاً (INSERT, UPDATE, DELETE), as the index must also be updated. However, for read-heavy analytical workloads, the benefit to SELECT speed is almost always worth it.
اتصال علم البيانات: يمنح فهم الفهارس متخصصي البيانات أداةً بسيطةً وفعّالةً للتغلب على اختناقات الأداء. فعند مواجهة استعلامات بطيئة على مجموعات بيانات ضخمة، يُعد إنشاء فهرس على الأعمدة المُفلترة غالبًا الخطوة الأولى والأكثر فعالية لتحسين الأداء.
الخلاصة الخامسة: توقف عن الثقة في مدخلات المستخدم
يؤدي إنشاء الاستعلامات عن طريق إدخال بيانات المستخدم مباشرةً في سلسلة نصية، كما هو الحال مع سلاسل f في بايثون، إلى ثغرة أمنية خطيرة تُعرف بهجوم حقن SQL. يحدث هذا عندما يُدخل مستخدم خبيث بيانات يتم تنفيذها كجزء من أمر SQL نفسه.
يتضمن المثال الكلاسيكي نموذج تسجيل الدخول. إذا كان الكود يُنشئ استعلامًا مثل f"SELECT * FROM users WHERE username = '{username}'", a user could enter a username of admin' --. The single quote closes the string, and the -- starts a SQL comment, causing the rest of the original query (including the password check) to be ignored. The database is tricked into logging the user in as ‘admin’ without a valid password. This is famously alluded to in the “Little Bobby Tables” webcomic.
الحل هو دائما تستخدم استعلامات ذات معلماتبدلاً من استخدام سلاسل f، يمكنك استخدام عنصر نائب (مثل ?) in your SQL string. You then provide the user’s input as a separate argument. The database library ensures that the input is treated strictly as data and never as executable code, completely preventing SQL injection attacks.
اتصال علم البيانات: تُعدّ هذه ممارسة أمنية بالغة الأهمية لأي شخص يُنشئ تطبيقات بيانات تفاعلية، أو لوحات معلومات، أو أي أداة تستعلم عن قاعدة بيانات بناءً على عوامل تصفية أو مدخلات يُدخلها المستخدم. يُعرّض عدم تحديد معايير الاستعلامات بياناتك وأنظمتك لمخاطر جسيمة.
ما يجب تقديمه اليوم
- عند قراءة ملف CSV في بايثون، استخدم
csv.DictReaderinstead of accessing columns by number. - قبل كتابة حلقة تكرارية في بايثون لتجميع البيانات، اسأل نفسك: "هل يمكن أن يكون هذا عنصرًا واحدًا؟"
GROUP BYquery in SQL?” - إذا رأيت نفس قيمة النص تتكرر عدة مرات في جدول بيانات، ففكر في تقسيم البيانات إلى جدولين مرتبطين بمعرف فريد.
- إذا لم تكن الجامعة المرغوب التقدم اليها غير مذكورة أعلاه ، فاتصل بنا للحصول على
SELECTquery with aWHEREclause is slow, create anINDEXon the column(s) in theWHEREclause. - لا تستخدم أبدًا سلاسل f أو دمج السلاسل لإضافة مدخلات المستخدم إلى استعلام SQL. استخدم دائمًا العناصر النائبة.
إغلاق
على الرغم من سهولة استخدام لغة برمجة عامة مثل بايثون لكل مهمة، إلا أن هذه المحاضرة من CS50 تُبين أن مفاهيم علوم الحاسوب الأساسية تُقدم مزايا عملية قوية في مجال تحليل البيانات. تُعد هذه المحاضرة جزءًا من سلسلة شاملة تُوضح كيف تُساهم المواضيع الأساسية في الحوسبة بشكل مباشر في تحسين جودة وكفاءة تحليل البيانات. من خلال تبني الطبيعة التصريحية للغة SQL، ومبادئ نمذجة البيانات السليمة، وميزات الأداء، يُمكن لمتخصصي البيانات كتابة برامج ليست أسرع فحسب، بل أكثر قوة وأسهل فهمًا أيضًا.
ما هي إحدى مهام البيانات الروتينية التي تقوم بها في بايثون والتي قد تكون عبارة عن استعلام SQL واحد وتصريحي بدلاً من ذلك؟





