


ما يغفله علماء البيانات عن الذاكرة
دليل لمحللي البيانات والعلماء لكتابة أكواد أكثر قوة وكفاءة وقابلية للتنبؤ من خلال فهم كيفية عمل الذاكرة حقًا.
مقدمة: الأخطاء التي لا تكمن في منطقك
لديك Python برنامج نصي يعمل بشكل مثالي على عينة صغيرة من البيانات ولكنه يتعطل برسالة غامضة MemoryError on the full dataset. Or maybe you’ve encountered a bug in a data pipeline that vanishes when you try to debug it step-by-step. These frustrating problems often have nothing to do with a flaw in your business logic and everything to do with a gap in understanding what the computer is doing “under the hood.”
تستند العديد من هذه المشكلات المعقدة وغير المتوقعة إلى مفاهيم أساسية في علوم الحاسوب تتعلق بالذاكرة. وفهمها ليس مجرد تمرين أكاديمي، بل هو مهارة عملية لكتابة برامج أفضل وأكثر موثوقية. هذا المقال هو خلاصة لمحاضرة CS50x 2025 (جامعة هارفارد) حول الذاكرة، والمتاحة على يوتيوب.
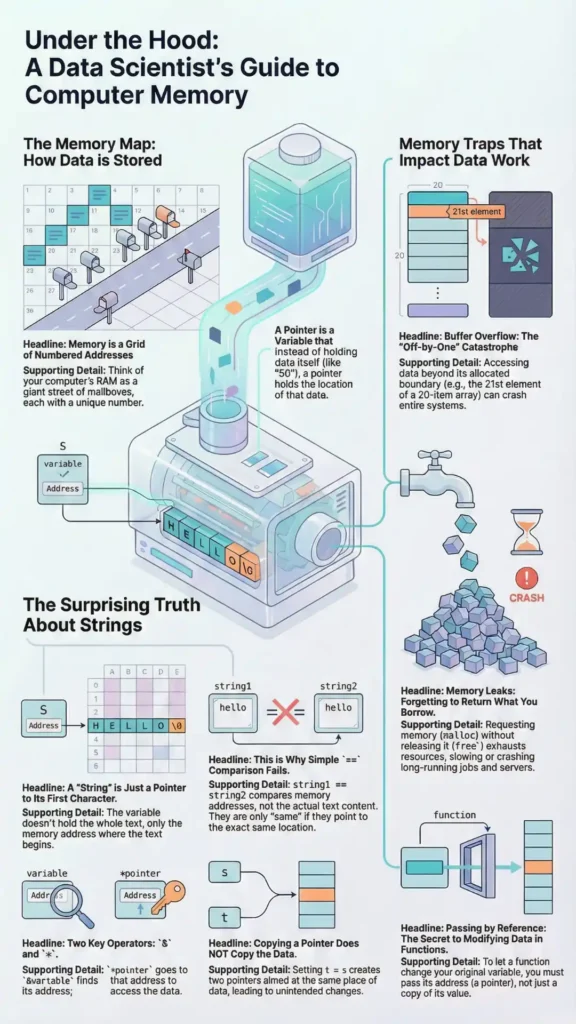
الخلاصة الأولى: "الخيط" وهم
في العديد من السياقات التمهيدية، أ string is presented as a basic data type. The CS50 library, for instance, uses it as a helpful “training wheel” to get students started. However, in a foundational language like C, there is no built-in string data type. It’s an abstraction.
ما نسميه سلسلة نصية هو في الواقع char *—a pointer to a character. This pointer is simply the memory address of the الأول حرف في سلسلة. لمعرفة مكان انتهاء السلسلة، تعتمد لغة C على قيمة حارس خاصة: مُنهي السلسلة الفارغ ( ).\0), a byte containing all zeros. Functions like printf read from the starting address character by character until they hit this null terminator. Without it, the function would just keep reading into adjacent memory, causing unpredictable behavior.
اتصال علم البيانات: يُعدّ هذا المفهوم أساسًا لكيفية تعامل لغات البرمجة عالية المستوى مثل بايثون و R مع السلاسل النصية وغيرها من البيانات ذات الأطوال المتغيرة. وهو يُفسّر سبب كون معالجة السلاسل النصية مُكلفة حسابيًا؛ إذ غالبًا ما يبحث النظام عن نقطة إنهاء أو يُدير المصفوفات الأساسية. بالنسبة لعلماء البيانات، يُعدّ هذا الأمر بالغ الأهمية عند تحليل ملفات النصوص الخام أو العمل مع واجهات برمجة التطبيقات (APIs)؛ إذ يُمكن أن يؤدي بايت إنهاء مفقود أو غير صحيح إلى تلف البيانات أو فشل التحليل، مثل قراءة سطر من ملف سجل بشكل غير صحيح واقتطاع معلومات خطأ مهمة.
الخلاصة الثانية: لماذا == Can Lie About Equality
عند مقارنة متغيرين صحيحين في لغة C باستخدام ==, you’re comparing their values. But if you compare two string variables with ==, you are not comparing their content. Instead, you are comparing their memory عناوين.
إذا كان لديك سلسلتان نصيتان متطابقتان، "high" و "high"، ولكنهما مخزنتان في مواقع مختلفة في الذاكرة، فإن == operator will return false. Their content is the same, but their addresses are different. This is why C requires a special function like strcmp (string comparison), which performs a character-by-character check to determine if the strings’ values are truly identical.
اتصال علم البيانات: هذا تشابه مباشر مع مفهوم هوية الكائن مقابل تساوي القيمة في بايثون. باستخدام is in Python compares memory addresses (identity), while == typically compares values (equality). For complex objects like Pandas DataFrames, even == can be ambiguous. This is why dedicated methods like pandas.DataFrame.equals() exist. The fundamental C behavior explains why you can’t just compare two DataFrames with a simple operator; you need a robust method that iterates through and compares their actual contents, just like strcmp does for C strings.
الخلاصة الثالثة: قد تكون النسخة مجرد اسم مستعار
في لغة C، تعليمات مثل string t = s; might look like it’s creating a new copy of string s and naming it t. It is not. This operation does not copy the string’s content (the characters ‘H’, ‘I’, ‘!’, ‘\0’). It only copies the العنوان الحرف الأول من السلسلة.
وهذا يعني كلا المتغيرين، s و t, now point to the exact same block of memory. They are two different names for the same underlying data. Consequently, if you modify the string using the variable t (for example, by capitalizing the first letter), you are also changing the string for s. There is only one string, and both variables point to it.
اتصال علم البيانات: هذا هو أصل مشكلة "العرض مقابل النسخ" التي تُربك مستخدمي Pandas في كثير من الأحيان. قد يقوم عالم البيانات بتصفية DataFrame، وتعيينه لمتغير جديد، ثم يبدأ بإجراء التغييرات، معتقدًا أنه يعمل على نسخة مستقلة. ولكن إذا أعادت Pandas "عرضًا" (اسمًا بديلًا يشير إلى البيانات الأصلية)، فإنه يُغير مجموعة البيانات المصدرية دون قصد. قد يؤدي هذا إلى أخطاء دقيقة وخطيرة يصعب تتبعها، حيث يتم تعديل البيانات الأصلية "بشكل غامض" بواسطة عملية تُنفذ في مكان آخر.
"عند استخدام دالة `equals` لمقارنة سلسلتين نصيتين... أي مقارنة عنواني البيانات، من الواضح أنهما في مكانين مختلفين... كنا بحاجة إلى حل لهذه المشكلة، ولذلك قدمنا دالة `strix` التي تعالجها بشكل صحيح." - محاضرة من جامعة هارفارد CS50x 2025 (يوتيوب) - الذاكرة
الخلاصة الرابعة: الذاكرة مورد محدود يجب عليك إدارته
عندما يحتاج برنامج ما إلى ذاكرة أثناء تشغيله - على سبيل المثال، لتخزين البيانات المقروءة من ملف - يمكنه طلبها من نظام التشغيل. في لغة C، يتم ذلك باستخدام دالة تسمى malloc() (memory allocation), which asks for a specific number of bytes from a large memory pool called the “heap.”
لكن هذا الطلب قد يفشل. إذا نفدت الذاكرة المتاحة في النظام، malloc() will return NULL (a special pointer to address zero) to signal failure. Robust code must always check for this possibility. Furthermore, once the program is finished with that memory, it must explicitly return it to the system using free(). Failing to do so creates a “memory leak,” where the program holds onto memory it no longer needs, potentially causing it to run out of resources and crash over time.
اتصال علم البيانات: ينطبق هذا بشكل مباشر على التعامل مع مجموعات البيانات الكبيرة. فمحاولة تحميل ملف CSV أو Parquet ضخم في إطار بيانات Pandas قد تتسبب بسهولة في تعطل البرنامج النصي إذا طلب ذاكرة أكبر مما هو متاح في النظام. مبادئ malloc و free are fundamental to writing scalable data pipelines, understanding why certain processes are “memory-bound,” and appreciating the design of modern data tools that use techniques like chunking or memory mapping to process data that won’t fit into memory all at once.
الخلاصة الخامسة: للوظائف مساحات عمل خاصة (المكدس)
عند استدعاء دالة، فإنها تحصل على مساحة عمل خاصة بها في منطقة من الذاكرة تسمى "المكدس". يحتوي "إطار المكدس" هذا على متغيراته المحلية، بما في ذلك الوسائط التي تم تمريرها إليه.
توضح محاضرة CS50 ذلك من خلال swap function intended to swap two integer values. The initial version fails because it only swaps نسخ يتم تمرير القيم الموجودة داخل إطار مكدس خاص بها. يُعرف هذا باسم "التمرير بالقيمة". بمجرد انتهاء الدالة، يختفي إطار المكدس الخاص بها، وتختفي المتغيرات الأصلية في الدالة المستدعِية (main) are left completely unchanged. The corrected version works by “pass by reference”—passing the memory عناوين من المتغيرات الأصلية. وهذا يعطي swap function the power to reach back into the caller’s stack frame and modify the original variables directly.
اتصال علم البيانات: يُعدّ هذا المفهوم أساسيًا لفهم نطاق المتغيرات وقابليتها للتغيير عند كتابة دوال تحويل البيانات. فهو يُفسّر سبب عدم قيام الدالة بتعديل إطار البيانات المُمرّر إليها كما هو متوقع (على سبيل المثال، إذا أعادت تعيين قيمة المتغير داخليًا بدلًا من تعديل الكائن في مكانه). كما يُؤكّد على مبادئ تصميم "الدوال النقية" - أي الدوال التي لا تُعدّل مُدخلاتها - والتي تُعدّ ضرورية لإنشاء مسارات تحليل قابلة للتكرار والاختبار وخالية من الأخطاء.
الخلاصة السادسة: خطأ المليار دولار هو خطأ في الحساب بمقدار واحد
يحدث "تجاوز سعة المخزن المؤقت" عندما يحاول برنامج كتابة بيانات تتجاوز حدود المخزن المؤقت المخصص له في الذاكرة، مثل المصفوفة. يشبه الأمر محاولة سكب جالون من الماء في كوب صغير - يجب أن يذهب الفائض إلى مكان ما، وغالبًا ما يؤدي ذلك إلى الكتابة فوق الذاكرة المجاورة، مما يتسبب في تلف البيانات وتعطل البرنامج.
تُشير المحاضرة إلى حادثة واقعية تتعلق ببرنامج الأمان CrowdStrike. تسبب خطأ برمجي في تحديث البرنامج في تعطل الأنظمة في جميع أنحاء العالم. كان السبب الجذري بسيطًا بشكل مذهل: توقع البرنامج مصفوفة تحتوي على 20 قيمة، لكنه استقبل 21 قيمة. أدت محاولة الوصول إلى العنصر الحادي والعشرين غير الموجود إلى خطأ "قراءة خارج نطاق الذاكرة"، مما تسبب في انهيار النظام. لا توفر لغة C أي حماية تلقائية ضد هذا النوع من الأخطاء البرمجية، مما يجعلها مثالًا قويًا على فئة خطيرة من هذه الأخطاء.
اتصال علم البيانات: هذا هو الدرس الأمثل في البرمجة الدفاعية لمعالجة البيانات. عند تحليل الملفات، أو تكرار عناصر القوائم، أو معالجة استجابات واجهة برمجة التطبيقات (API)، لا يمكنك الوثوق بأن البيانات الواردة تتوافق مع توقعاتك. تُبرز هذه الثغرة الأمنية منخفضة المستوى أهمية معالجة الأخطاء والتحقق من صحة المدخلات على مستوى عالٍ. احرص دائمًا على إضافة فحوصات صريحة للتحقق من التنسيقات والأحجام والحدود المتوقعة قبل معالجة البيانات لمنع انهيار مسار المعالجة بالكامل بسبب قيمة واحدة غير متوقعة.
ما يجب تقديمه اليوم: قائمة مرجعية عملية
- دقق في معايير المساواة الخاصة بك: عند مقارنة كائنات معقدة مثل النماذج أو جداول البيانات، توقف وتأكد مما إذا كنت بحاجة إلى معرفة ما إذا كانت هي نفس الشيء تمامًا في الذاكرة (الهوية) أو إذا كانوا ببساطة تحتوي على نفس البيانات (المساواة). استخدم الطريقة المناسبة (
isمقابل..equals()) for your goal. - راجع تعديلات إطار البيانات الخاص بك: قبل تعديل ما تعتقد أنه نسخة من DataFrame، تحقق بوضوح مما إذا كان عرضًا أم نسخة. قد يؤدي تغيير بسيط في العرض إلى إتلاف مجموعة البيانات الأصلية دون أن تشعر. استخدم
.copy()to ensure you have an independent object. - كن استباقياً بشأن الذاكرة: عند التعامل مع الملفات الكبيرة، لا تكتفِ بتحميلها وتأمل أن تسير الأمور على ما يرام. استخدم أدوات للتحقق من ذاكرة النظام المتاحة، وقم بمعالجة الملفات على أجزاء أصغر (على سبيل المثال، باستخدام
chunksizeفيpandas.read_csv) to avoid requesting more memory than is available. - التحقق من صحة حدود البيانات: عند الوصول إلى البيانات باستخدام فهرس، كما هو الحال في القوائم أو المصفوفات، اعتبره نقطة ضعف محتملة. أضف فحوصات للتأكد من أن الفهرس ضمن النطاق المتوقع، خاصةً عندما يتم تحديد حجم البيانات من مصدر خارجي.
- لا تثق أبدًا في بيانات الإدخال: تعامل مع البيانات الواردة من الملفات أو واجهات برمجة التطبيقات أو مدخلات المستخدم على أنها غير موثوقة بشكل أساسي. قبل إجراء أي عمليات، أضف تأكيدات أو فحوصات صريحة لأنواع البيانات وأحجامها وتنسيقاتها لاكتشاف المشكلات غير المتوقعة قبل أن تؤثر سلبًا على تحليلك.
9. خواطر ختامية
لا تُعدّ مفاهيم الذاكرة منخفضة المستوى هذه مجرد معلومات أكاديمية هامشية، بل تظهر مباشرةً على شكل أخطاء، واختناقات في الأداء، ومخاطر أمنية نواجهها في أعمال علوم البيانات المتقدمة. بفهم ما يحدث في الذاكرة، ننتقل من الحيرة بسبب الأعراض إلى تشخيص السبب الجذري. ومع تقدّم دورة CS50، تُصبح هذه المبادئ نفسها اللبنات الأساسية لإنشاء هياكل بيانات فعّالة تُشغّل قواعد البيانات والخوارزميات.
ما هو الخطأ "الغريب" الأخير في التعليمات البرمجية الخاصة بك والذي يمكن تفسيره الآن بأحد مبادئ الذاكرة الأساسية هذه؟




