


هياكل البيانات: دليل عالم البيانات
تساعد هذه المقالة ممارسي البيانات على فهم هياكل البيانات الأساسية لكتابة تعليمات برمجية أسرع وأكثر كفاءة في استخدام الذاكرة.
غالباً ما تُعزى إحدى المشكلات الشائعة في برامج معالجة البيانات، بدءاً من بطء حلقات هندسة الميزات وصولاً إلى عمليات البحث غير الفعّالة، إلى عدم التوافق بين المهمة وبنية البيانات الأساسية المستخدمة. لا يكمن السبب الجذري لهذه المشكلات في منطق الكود، بل في كيفية تنظيم البيانات في الذاكرة. يُعدّ فهم هذه البنى - وموازناتها - مهارة أساسية لكتابة مسارات تحليل فعّالة وقابلة للتوسع. ستُقدّم هذه المقالة ملخصاً لأهم الدروس حول بنى البيانات من دورة CS50x الشهيرة بجامعة هارفارد، رابطةً أساسيات علوم الحاسوب هذه مباشرةً بعالم تحليل البيانات وعلم البيانات العملي. هذه المقالة مُلخّصة بناءً على دورة CS50x 2025 (جامعة هارفارد) على يوتيوب.
1. المصفوفات وتكاليف تغيير حجمها الخفية
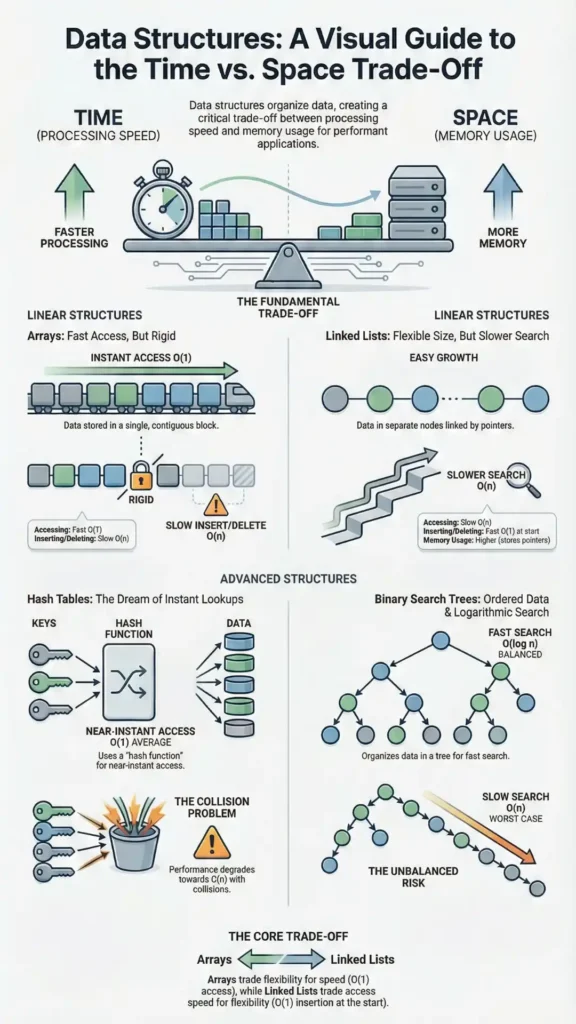
المصفوفة هي بنية بيانات بسيطة تُخزَّن فيها العناصر من النوع نفسه بشكل متجاور في الذاكرة. هذا الترتيب المتجاور يجعل الوصول إلى أي عنصر بواسطة فهرسه سريعًا للغاية. مع ذلك، تُعاني المصفوفات من قيدٍ هام: يجب تحديد حجمها مسبقًا.
ماذا يحدث عندما تحتاج إلى "توسيع" مصفوفة ممتلئة؟ لا يمكنك ببساطة إضافة عنصر جديد في النهاية إذا كان موقع الذاكرة مشغولاً بالفعل. الحل الوحيد هو تخصيص كتلة ذاكرة جديدة أكبر حجمًا، ونسخ كل عنصر يدويًا من المصفوفة القديمة إلى الجديدة، ثم تحرير الذاكرة التي كانت تشغلها المصفوفة الأصلية. عملية النسخ هذه تستغرق وقتًا طويلاً، وتعتمد على "الوقت الخطي" - فكلما كبرت المصفوفة، زاد الوقت اللازم للنسخ.
اتصال علم البيانات
تتصرف العديد من أدوات البيانات الشائعة، مثل قوائم بايثون، كـ"مصفوفات ديناميكية". ورغم أنها تبدو وكأنها تنمو تلقائيًا، إلا أنها تُجري عملية تغيير الحجم المكلفة هذه في الخلفية. ولتسريع عملية الإضافة، تستخدم قوائم بايثون التخصيص الزائد- أي حجز مساحة إضافية - مما ينتج عنه وقت ثابت مُستهلك (O(1)) للإضافة. مع ذلك، فإن إدراج عنصر في بداية قائمة كبيرة بطيء ليس فقط بسبب احتمالية تغيير الحجم، بل لأنه يتطلب إزاحة كل عنصر لاحق خانة واحدة إلى اليمين، وهو ما يُكلف O(n) بشكل مباشر.
2. القوائم المرتبطة: استبدال الذاكرة المتجاورة بالمرونة
تُقدّم القائمة المتصلة حلاً لمشكلة تغيير حجم المصفوفة بشكل ثابت. فبدلاً من تخزين العناصر بشكل متجاور، تتكون القائمة المتصلة من سلسلة من "العُقد" التي يمكن وضعها في أي مكان في الذاكرة. تحتوي كل عقدة على عنصرين: جزء من البيانات و"مؤشر" (عنوان) يُشير إلى موقع العقدة التالية. وهذا يسمح لك بربط مواقع الذاكرة المتاحة حسب الحاجة.
يُقدّم هذا الهيكل مقايضة أساسية:
- رأسا على عقل: يمكن للقائمة أن تنمو وتتقلص ديناميكيًا دون الحاجة إلى نقل جميع العناصر الموجودة. وهذا يُحسّن استخدام الذاكرة المجزأة.
- الجانب السلبي: إنها تستخدم ذاكرة أكبر بشكل عام، لأن كل عنصر يتطلب مؤشرًا إضافيًا لتخزين عنوان العنصر التالي.
- الجانب السلبي الرئيسي: تفقد القدرة على إجراء بحث ثنائي سريع. ولأن العناصر لا تُخزّن بشكل متجاور، لا يمكنك الانتقال مباشرةً إلى منتصف القائمة؛ بل يجب عليك اجتيازها عقدةً تلو الأخرى بدءًا من البداية.
اتصال علم البيانات
لنفترض وجود سجل أحداث في الوقت الفعلي، حيث قد يلزم إدراج أحداث أو إزالتها من منتصف تسلسل بناءً على التحديثات. باستخدام لغة بايثون القياسية list would be punishingly slow for this, as each operation could require shifting many elements. A structure like Python’s collections.deque, however, is implemented using a doubly-linked list, providing fast O(1) appends and pops from على حد سواء الغايات.
3. الحقيقة غير البديهية: أسرع قائمة تُبنى بالمقلوب
عند التعامل مع القوائم المتصلة، تؤثر طريقة إضافة العناصر الجديدة بشكل كبير على الأداء. لإضافة عقدة جديدة إلى بداية القائمة (إضافة عنصر في البداية)، يكفي إنشاء العقدة الجديدة وتحديث مؤشرين في رأس القائمة. هذه العملية مستقلة عن الحجم الإجمالي للقائمة.
هذا يجعل عملية الإضافة في بداية القائمة عمليةً ذات زمن ثابت (O(1)) ، أي أنها سريعة للغاية. في المقابل، لإضافة عقدة جديدة إلى نهاية القائمة (الإضافة في نهايتها)، يجب أولاً المرور على القائمة بأكملها من البداية للعثور على العقدة الأخيرة. هذا يجعل عملية الإضافة في نهايتها عمليةً ذات زمن خطي (O(n)) ، والتي تتباطأ تدريجياً مع ازدياد حجم القائمة.
النتيجة المفاجئة هي أن الطريقة الأمثل لإنشاء قائمة مرتبطة من الصفر هي إضافة كل عنصر جديد في البداية. هذا يعني أنه إذا أدخلت الأرقام 1، ثم 2، ثم 3، فستكون القائمة النهائية في الذاكرة على النحو التالي: 3 -> 2 -> 1.
اتصال علم البيانات
هذا مثال كلاسيكي يوضح كيف يمكن لاختيار بسيط ظاهريًا - الإضافة إلى البداية أو النهاية - أن يُحدث تأثيرًا هائلًا على الأداء (O(1) مقابل O(n)). يُبرز هذا أهمية فهم التعقيد الزمني للعمليات التي نستخدمها يوميًا في تنظيف البيانات وكتابة برامج هندسة الميزات. قد تخفي حلقة بطيئة عملية خطية يمكن تحسينها.
4. أشجار البحث الثنائية: عمليات بحث سريعة قد تتدهور.
تحاول شجرة البحث الثنائية (BST) الجمع بين أفضل ما في كلا العالمين: سرعة البحث التي توفرها المصفوفات المرتبة، وإمكانية تغيير حجم القوائم المتصلة ديناميكيًا. وهي عبارة عن شجرة من العقد، حيث تحتوي كل عقدة على ما يصل إلى عقدتين فرعيتين. ويخضع هيكلها لخاصية البحث الثنائي: فبالنسبة لأي عقدة معينة، تكون جميع القيم في شجرتها الفرعية اليسرى أصغر، وجميع القيم في شجرتها الفرعية اليمنى أكبر.
تتيح هذه الخاصية إجراء بحث ثنائي باتباع المؤشرات اليسرى أو اليمنى أسفل الشجرة، مما يحقق أداءً فعالاً في زمن لوغاريتمي (O(log n)) في المتوسط. مع ذلك، تعاني شجرة البحث الثنائية من عيب جوهري. ففي الحالة الشاذة التي يتم فيها إدخال بيانات مرتبة مسبقًا (مثل إدخال 1، ثم 2، ثم 3، ثم 4)، تصبح الشجرة غير متوازنة تمامًا. إذ تُضاف كل عقدة جديدة ببساطة إلى يمين العقدة السابقة.
في أسوأ سيناريو، تتحول شجرة البحث الثنائية إلى قائمة مرتبطة. ويتدهور أداء البحث من وقت لوغاريتمي إلى زمن خطي (O(n)).
اتصال علم البيانات
تُعدّ شجرة البحث الثنائية غير المتوازنة استعارةً بليغةً للفرق بين الأداء في الحالة المتوسطة وأسوأ الحالات. في علم البيانات، يُمكن أن يؤثر توزيع بيانات الإدخال وترتيبها بشكلٍ كبير على كفاءة الخوارزمية. لهذا السبب، تتطلب فهارس قواعد البيانات، التي غالبًا ما تعتمد على هياكل شجرية، خوارزميات "موازنة" معقدة لإعادة تنظيم نفسها باستمرار ومنع حدوث أسوأ سيناريو.
5. جداول التجزئة: الطريق العملي إلى وقت ثابت
يُعدّ جدول التجزئة بنية البيانات الأمثل لتنفيذ القواميس، التي تخزن أزواج المفاتيح والقيم. فهو يجمع ببراعة بين المصفوفات والقوائم المتصلة لتحقيق عمليات بحث شبه فورية. ومكوناته الأساسية هي:
- An مجموعة من "الدلاء".
- A دالة التجزئة يأخذ مفتاحًا (مثل اسم شخص) ويحوله بشكل حتمي إلى فهرس للمصفوفة.
- القوائم المرتبطة داخل كل مجموعة للتعامل مع "التصادمات" - الحالات التي يتم فيها تجزئة مفتاحين مختلفين إلى نفس فهرس المصفوفة.
يُجسّد تشبيه المحاضرة بأرفف استلام الطلبات في سويتغرين هذا المفهوم خير تجسيد. اسمك في الطلب هو المفتاح مفتاحالموظف الذي ينظر إلى الحرف الأول من اسمك لاختيار رف (AE، FJ، إلخ) هو دالة التجزئة. الرف نفسه هو الدلو (مؤشر في المصفوفة). السلطات القليلة الموجودة على هذا الرف والتي عليك تصفحها تُمثل القائمة المرتبطة لمعالجة التصادمات. في حين أن أسوأ حالة نظرية هي زمن خطي (O(n)) إذا تصادمت جميع المفاتيح في قائمة مرتبطة طويلة واحدة، فإن الأداء العملي في الحالة المتوسطة قريب بشكل ملحوظ من زمن ثابت (O(1)).
نعم، من الناحية التقنية، تُحسب جداول التجزئة بوحدة N مقسومة على K، وهي في الواقع ببساطة O(n) الكبيرة، ولكن عمليًا، إذا كنت ذكيًا وحسن اختيار دالة التجزئة التي تستخدمها، فمن المرجح أن يكون احتمال التصادمات منخفضًا جدًا، حتى أنه حتى لو تحول الأمر أحيانًا إلى وقت خطي، فسيكون في معظم الأحيان وقتًا ثابتًا، أي O(1) الكبيرة. — محاضرة: هياكل البيانات، جامعة هارفارد، CS50x 2025 (يوتيوب)
اتصال علم البيانات
تُعد جداول التجزئة المحرك الأساسي لقواميس بايثون (dict) and sets (set). This is why key lookups (my_dict['key']) and membership testing (item in my_set) are exceptionally fast. These structures are fundamental tools for performant data manipulation, creating lookup tables, aggregating data by category, and building features efficiently.
ما يجب تقديمه اليوم
- يُفضل دائمًا استخدام القاموس/خريطة التجزئة للبحث عن القيم الرئيسية مقارنة بالبحث في قائمة من الأزواج. يكون فرق الأداء بين O(1) و O(n) هائلاً على مجموعات البيانات الكبيرة.
- انتبه لترتيب البيانات عندما يكون الأداء مهماً. كما هو الحال مع أشجار البحث الثنائية، فإن إدخال البيانات المصنفة في هياكل معينة يمكن أن يؤدي إلى أسوأ سلوك ممكن.
- اسأل عما إذا كانت بياناتك بحاجة إلى ترتيب. إذا كنت تحتاج فقط إلى عمليات بحث سريعة واختبارات عضوية، فإن المجموعة (القائمة على التجزئة) أكثر كفاءة بكثير من القائمة.
- تخيل العمليات الأساسية. عندما يكون البرنامج النصي بطيئًا، فكر فيما إذا كنت تجبر عملية خطية من الرتبة O(n) داخل حلقة تكرارية، مما يؤدي عن غير قصد إلى إنشاء تعقيد من الرتبة O(n²).
- أدرك المفاضلة بين الزمان والمكان. جدول التجزئة (مثل بايثون)
dict) consumes more memory than a list to store its hash values and pointers, but it buys you dramatically faster lookups—a trade-off that is essential to writing performant code.
إغلاق
الفكرة الأساسية هي أن كل بنية بيانات تمثل مفاضلة بين الوقت والمساحة وتعقيد التنفيذ. لا توجد بنية "أفضل" مطلقًا، بل البنية الأنسب للمهمة المطلوبة. ينتقل الحديث بعد ذلك إلى لغة بايثون، وهي لغة تُجرّد الكثير من تفاصيل إدارة الذاكرة اليدوية التي ناقشناها. مع ذلك، تظل مبادئ الأداء بنفس القدر من الأهمية، لأن هذه البنى لا تزال تعمل في الخلفية. أي بنية بيانات تستخدمها يوميًا ستفكر فيها الآن بشكل مختلف؟



