


دروس في علوم الحاسوب حول كيفية عمل الذكاء الاصطناعي فعلياً
بالنسبة لمحللي البيانات والعلماء، فإن هذا التحليل لمحاضرة في علوم الحاسوب بجامعة هارفارد يحول نظرية علوم الحاسوب إلى حكمة عملية لعملك اليومي.
مقدمة: التكلفة الخفية لـ "إنها تعمل ببساطة"
هل سبق لك أن واجهت صعوبة في تصحيح مخرجات نموذج غريبة أو شرح تنبؤ غامض لأحد أصحاب المصلحة؟ في علم البيانات، نستخدم غالبًا أدوات قوية تبدو وكأنها تعمل تلقائيًا، إلى أن تتعطل. غالبًا ما ينبع الإحباط من النتائج غير المتوقعة من فجوة بين استخدام الأداة وفهم مبادئها الأساسية. من خلال النظر إلى مشاكل البيانات الحديثة من منظور علوم الحاسوب الأساسية، يمكننا الانتقال من مجرد استخدام الأدوات إلى التحكم بها بثقة ووضوح. هذه المقالة هي خلاصة لمحاضرة CS50x 2025 (جامعة هارفارد) حول الذكاء الاصطناعي، والمتاحة على يوتيوب. وهي تُلخص المحاضرة في خمس نقاط عملية تربط نظرية علوم الحاسوب بالواقع العملي لتحليل البيانات، مما يمنحك مفاهيم قيّمة يمكنك تطبيقها فورًا.
الخلاصة الأولى: الذكاء الاصطناعي عبارة عن طيف يتراوح من القواعد البسيطة إلى الاحتمالات المعقدة
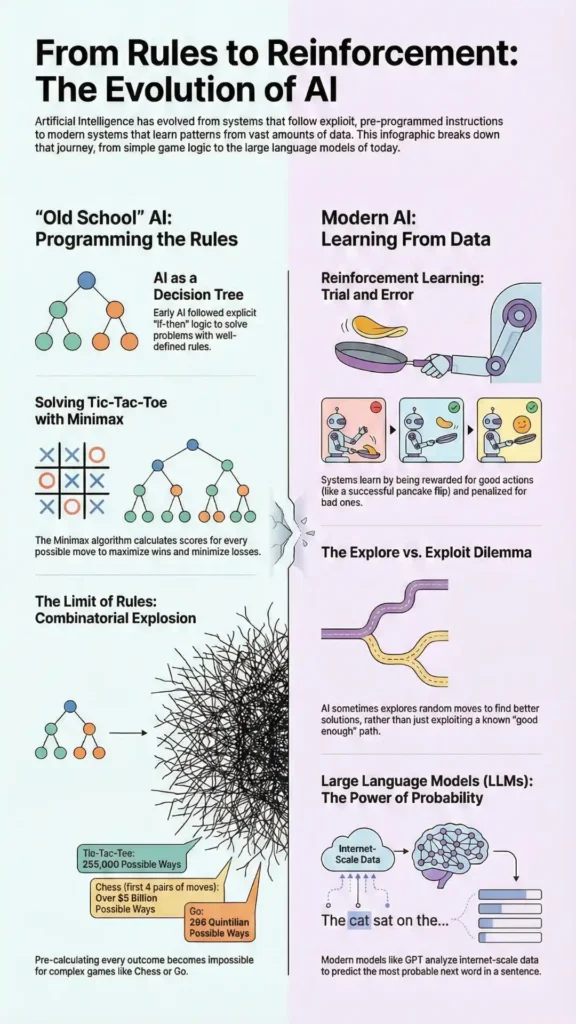
الذكاء الاصطناعي ليس كيانًا واحدًا متجانسًا، بل هو طيف واسع. ففي أحد طرفيه، نجد أنظمة بسيطة وحتمية. وتستخدم المحاضرة لعبة إكس-أو كمثال كلاسيكي. ويمكن بناء "ذكاء اصطناعي" لهذه اللعبة باستخدام... شجرة القرار—سلسلة من if-else rules—and an algorithm called مينيماكستُخصّص الخوارزمية نقاطًا لحالات رقعة الشطرنج (مثلًا، +1 للفوز، -1 للخسارة، 0 للتعادل)، ثم تعمل بشكل عكسي لاختيار النقلة التي تُحقق أفضل نتيجة ممكنة. هذا النهج شامل ويضمن الفوز أو التعادل. مع ذلك، لا يُمكن تطبيق هذا المنطق القائم على القواعد إلا في بيئات ذات قيود شديدة. كما هو موضح في المحاضرة، في لعبة أكثر تعقيدًا كالشطرنج، يوجد أكثر من 85 مليار طريقة للعب أول أربع مجموعات من النقلات فقط، مما يجعل إنشاء شجرة قرارات كاملة أمرًا مستحيلًا حسابيًا.
على النقيض تمامًا، توجد أنظمة حديثة تعتمد على الاحتمالات، مثل نماذج اللغة الكبيرة (LLMs). لا تتبع هذه النماذج قواعد صريحة، بل كما أوضحت المحاضرة، تعمل عن طريق التنبؤ بالكلمة التالية الأكثر احتمالًا في سلسلة من الكلمات، استنادًا إلى الأنماط والتكرارات الواسعة التي تعلمتها من بيانات التدريب. فهي تعمل على أساس الاحتمالات، لا على أساس اليقين.
اتصال علم البيانات: يتوافق هذا النطاق مباشرةً مع مناهج علم البيانات الشائعة. كتابة قواعد العمل الصريحة بلغة SQL، مثل CASE WHEN ... THEN, is like building a decision tree. In contrast, training a statistical model that assigns probabilities to different outcomes is working on the other end of the spectrum. Understanding where your specific business problem falls on this continuum—from needing deterministic rules to benefiting from probabilistic inference—is crucial for choosing the right tool for the job.
الخلاصة الثانية: "الهندسة الفورية" ليست سوى سياق منظم
إنّ مهارة "هندسة التوجيه" التي حظيت باهتمام كبير لا تتعلق كثيرًا بالأوامر المعقدة، بل بتوفير سياق منظم. تُبسط هذه المحاضرة هذا المفهوم باستخدام مساعد الذكاء الاصطناعي "البطة المطاطية" من CS50 كمثال مثالي. يتكون التوجيه من جزأين رئيسيين: توجيه النظام and the المستخدم. توجيه المستخدم هو ببساطة السؤال الذي يطرحه الشخص. أما توجيه النظام، الذي يكتبه المطور، فهو مجموعة من التعليمات التي تُخبر الذكاء الاصطناعي بكيفية التصرف والقيود التي يجب عليه اتباعها.
قام فريق CS50 بتزويد بطتهم بتعليمات نظام محددة للغاية لتشكيل سلوكها من نموذج عام لتعلم اللغة إلى مساعد تعليمي مفيد، ولكن ليس غشاشًا. تضمنت التعليمات أوامر مباشرة مثل:
"أنت مساعد تدريس ودود وداعم لمادة cs50."
"أنت أيضاً بطة مطاطية."
"لا تقدم إجابات كاملة لمجموعة المسائل لأن ذلك سيخالف الأمانة الأكاديمية."
توفر هذه التعليمات السياق اللازم للذكاء الاصطناعي لتوليد استجابة مفيدة ومحددة للمجال وآمنة، بدلاً من مجرد الإجابة الافتراضية.
اتصال علم البيانات: يُشابه هذا تمامًا تحديد نطاق وقيود أي مشروع لتحليل البيانات. لا يُعطى "التوجيه الأمثل" للتحليل للذكاء الاصطناعي، بل لك ولأصحاب المصلحة. قد يشمل ذلك تعريف المصطلحات التجارية الرئيسية ("ما الذي يُشكّل تحديدًا 'مستخدمًا نشطًا'؟")، وتحديد النطاق الزمني، أو ذكر السؤال التجاري الأساسي الذي تحاول الإجابة عنه. يمنع هذا الإطار الأولي إهدار الجهد وسوء الفهم، ويضمن أن يكون التحليل النهائي دقيقًا وذا صلة.
الخلاصة الثالثة: المفاضلة الحاسمة: الاستكشاف مقابل الاستغلال
يُعدّ مفهوم المعضلة بين الاستكشاف والاستغلال من أهمّ المفاهيم في الذكاء الاصطناعي. تُوضّح المحاضرة هذا المفهوم من خلال لعبة متاهة بسيطة، حيث يتعيّن على نظام ذكاء اصطناعي إيجاد مخرج أخضر مع تجنّب حفر الحمم البركانية. في البداية، يجد النظام a صحيحًا بالصدفة، ومن خلال التدريب، يتعلّم اتباعه مرارًا وتكرارًا. هذا هو الاستغلال- استخدام المعلومات المعروفة لتحقيق نتيجة مضمونة.
مع ذلك، قد لا يكون المسار الأول هو الأمثل . لإيجاد مسار أقصر وأكثر فعالية، يحتاج الذكاء الاصطناعي إلى إدخال قدر ضئيل من العشوائية، يُعرَّف في المحاضرة بـ"قيمة إبسيلون"، والتي تمثل احتمالًا محددًا (مثل 5% أو 10%) بأن يقوم النظام بحركة عشوائية بدلًا من أفضل حركة تعلمها. يشجع هذا على الاستكشاف- تجربة حركات جديدة وعشوائية حتى لو كان ذلك يعني المخاطرة بفشل مؤقت، كالسقوط في حفرة من الحمم البركانية. بمرور الوقت، تتيح هذه الفرصة الضئيلة للاستكشاف للذكاء الاصطناعي اكتشاف استراتيجيات أفضل.
تجلّى هذا المبدأ بوضوح في مثال الذكاء الاصطناعي الذي تعلّم لعبة "بريك آوت". ففي البداية، كان الذكاء الاصطناعي يكتفي بتحريك المضرب ذهابًا وإيابًا، لكنه اكتشف، من خلال التجربة، استراتيجيةً غير بديهية لكنها فعّالة للغاية، وهي توجيه الكرة إلى جانب واحد من الملعب، مما سمح للعبة بأن "تلعب نفسها" فعليًا، وحقق نقاطًا هائلة.
اتصال علم البيانات: يُعدّ هذا التوازن جوهريًا في عمل علم البيانات. اختبار A/B هو نسخة رسمية منه: إذ تستمر في استخدام النموذج الفائز المعروف (الاستغلال) بينما تختبر نسخة جديدة لمعرفة ما إذا كانت أفضل (الاستكشاف). ينطبق هذا على تحسين النماذج، حيث قد تُجرّب معلمات فائقة جديدة بدلًا من التمسك بتلك التي تعمل بكفاءة كافية. بل وينطبق أيضًا على التطوير المهني: هل تلتزم بالأدوات التي تعرفها (الاستغلال) أم تُخصّص وقتًا لتعلم لغة أو إطار عمل جديد قد يكون أكثر فعالية (الاستكشاف)؟
الخلاصة الرابعة: الحاصلون على درجة الماجستير في القانون هم بارعون في مطابقة الأنماط، وليسوا مفكرين تجريديين.
بحسب المحاضرة، فإن نماذج اللغة الكبيرة ليست أنظمة استدلال أو "تفكير" بالمعنى البشري، بل هي أنظمة متطورة للغاية لمطابقة الأنماط. تعتمد هذه النماذج على الشبكات العصبية، ويتم تدريبها مسبقًا على كميات هائلة من النصوص من الإنترنت. وتتمثل وظيفتها الأساسية في حساب الكلمة التالية الأكثر احتمالًا في سلسلة من الكلمات بناءً على الكلمات السابقة لها.
تُبسط المحاضرة الأمر ببساطة: "...إذا سألني أحدهم كيف حالك؟ بناءً على كل هذه البيانات، أراهن بنسبة 99% أن نموذج PT أو CS50 سيرد عليّ بـ "بخير، شكرًا، كيف حالك؟" النموذج ليس على ما يرام؛ إنه ببساطة يُولّد الاستجابة الأكثر ترجيحًا إحصائيًا بناءً على بيانات التدريب الخاصة به.
إن هذه الطبيعة الاحتمالية هي السبب المباشر للهلوسة. فعندما يُصرّح نموذج التعلم الآلي (LLM) بثقة بشيء غير صحيح من الناحية الواقعية، فذلك لأن الأنماط الموجودة في بيانات التدريب الخاصة به تُشير إلى أن العبارة الخاطئة عبارة عن سلسلة من الكلمات تبدو معقولة. إنه يُركّب جملة ذات احتمالية إحصائية، وليس يُثبت حقيقة.
اتصال علم البيانات: لهذا الأمر آثار بالغة الأهمية على متخصصي البيانات. لا ينبغي أبدًا اعتبار مخرجات نماذج التعلم الموجه (LLM) حقائق مطلقة، بل يجب اعتبارها فرضيات مدروسة جيدًا تتطلب التحقق من مصادرها الأصلية. هذه العقلية النقدية ضرورية للحفاظ على دقة التحليل. إن استخدام مخرجات نماذج التعلم الموجه دون التحقق منها يُعرّض التقارير ولوحات المعلومات والنماذج لخطر نشر معلومات مضللة، مما يُقوّض الثقة في العمل.
الخلاصة الخامسة: الحل الحقيقي للذكاء الاصطناعي هو نظام، وليس مجرد نموذج
نادراً ما تكون أداة الذكاء الاصطناعي المفيدة مجرد نموذج مستقل، بل هي نظام متكامل مبني حول هذا النموذج. يُقدّم هذا العرض "مخططاً معمارياً" لمصحح الأخطاء CS50 duck، يوضح هذه النقطة تماماً. لم يقم فريق CS50 ببناء نموذج التعلم القائم على اللغة (LLM) الخاص بهم من الصفر، بل ابتكروا أداة قيّمة من خلال دمج عدة مكونات رئيسية.
يتضمن النظام واجهة سهلة الاستخدام للطلاب، وقاعدة بيانات Vector محلية تُستخدم لتخزين محتوى المحاضرات المكتوبة والبحث فيه، بالإضافة إلى روابط مع استخدم لتخزين والبحث في محتوى المحاضرات المنسوخة، والاتصالات مع طرف ثالث واجهات برمجة تطبيقات خارجية من مزودين مثل OpenAI. لم يكمن الإنجاز الرئيسي للفريق في إنشاء نموذج أساسي جديد، بل في تجميع هذه العناصر في نظام يحل مشكلة تعليمية محددة بفعالية.
اتصال علم البيانات: هذا درسٌ بالغ الأهمية لعلماء البيانات، إذ يتطلب تحولاً في طريقة التفكير من "أبني النماذج" إلى "أصمم حلولاً قائمة على البيانات". فالقيمة الحقيقية للأعمال نادراً ما تكمن في نموذجٍ مستقل، مهما بلغت درجة تعقيده. إنما تكمن في النظام: مسارات البيانات التي تغذي النموذج، وواجهات برمجة التطبيقات التي تُتيح له التنبؤ، والواجهات التي تجعله قابلاً للاستخدام. التفكير كمهندس معماري يعني توسيع نطاق تركيزك من تحسين الخوارزمية إلى تصميم نظام متكامل لحل المشكلات.
ما يجب تقديمه اليوم
- قم بصياغة "مُوجِّه النظام" لمشروعك القادم: قبل كتابة أي كود، اكتب فقرة تحدد فيها أهدافك وقيودك وتعريفاتك الرئيسية، تمامًا مثل موجه CS50 duck.
- تحديد الفرق بين الاستكشاف والاستغلال: في عملك الحالي، ابحث عن مجال واحد تستغل فيه عملية معروفة. اسأل نفسك كيف يمكن أن تبدو تجربة استكشافية صغيرة.
- تحويل المشكلة إلى شجرة قرارات: استخدم السبورة البيضاء لعرض مشكلة تجارية بسيطة.
if-then-elselogic of a decision tree. Does this clarify the logic? - التحقق، لا تثق: تعامل مع المعلومة التالية التي تحصل عليها من الذكاء الاصطناعي التوليدي كفرضية. خصص ثلاث دقائق لمحاولة التحقق منها من مصدر أساسي.
- التفكير في الأنظمة: عند بناء نموذج، ارسم مخططًا بسيطًا للمدخلات التي يحتاجها والمخرجات التي سينتجها. كيف سيستخدمه شخص أو نظام آخر؟
الخاتمة: من البرمجة إلى الإدراك
إن فهم المبادئ الأساسية لعلوم الحاسوب التي يقوم عليها الذكاء الاصطناعي لا يقتصر على تبسيط هذه التقنية فحسب، بل يمنحك إطارًا للتحكم والوضوح والتفكير النقدي. فمفاهيم مثل أشجار القرار، والاستدلال الاحتمالي، والمفاضلة بين الاستكشاف والاستغلال، ليست مجرد نظريات مجردة، بل أدوات عملية لبناء حلول بيانات أكثر قوة وموثوقية. تشكل هذه الأفكار الأساس الذي يمكنك من خلاله بناء فهم أعمق لمواضيع أكثر تقدمًا. ومع ازدياد اندماج هذه الأنظمة الاحتمالية في أدواتنا، كيف سنحتاج إلى تكييف أساليبنا لضمان دقة التحليل؟





